크루위키 DB를 날려먹었어요
원문: 리로그에서 읽기
청천벽력
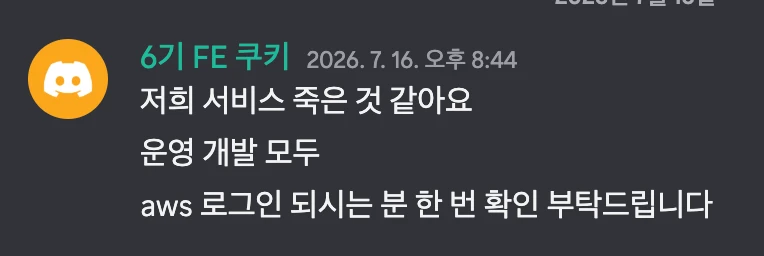
크루위키의 서버가 모두 멈췄다는 메시지를 받았다.
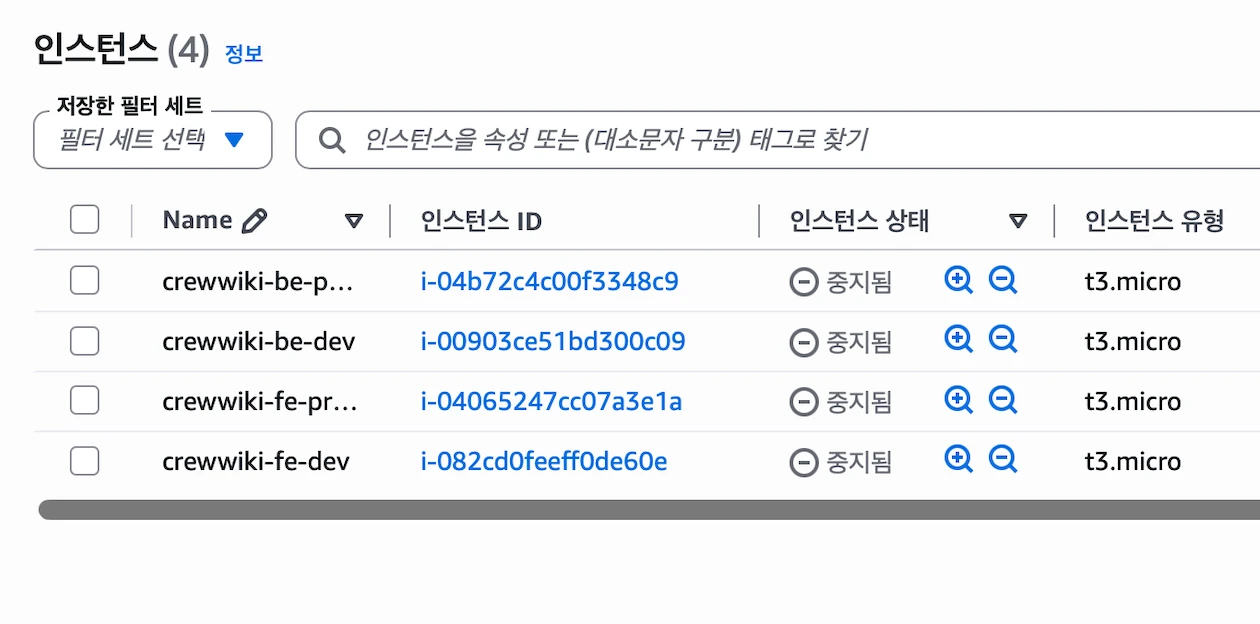
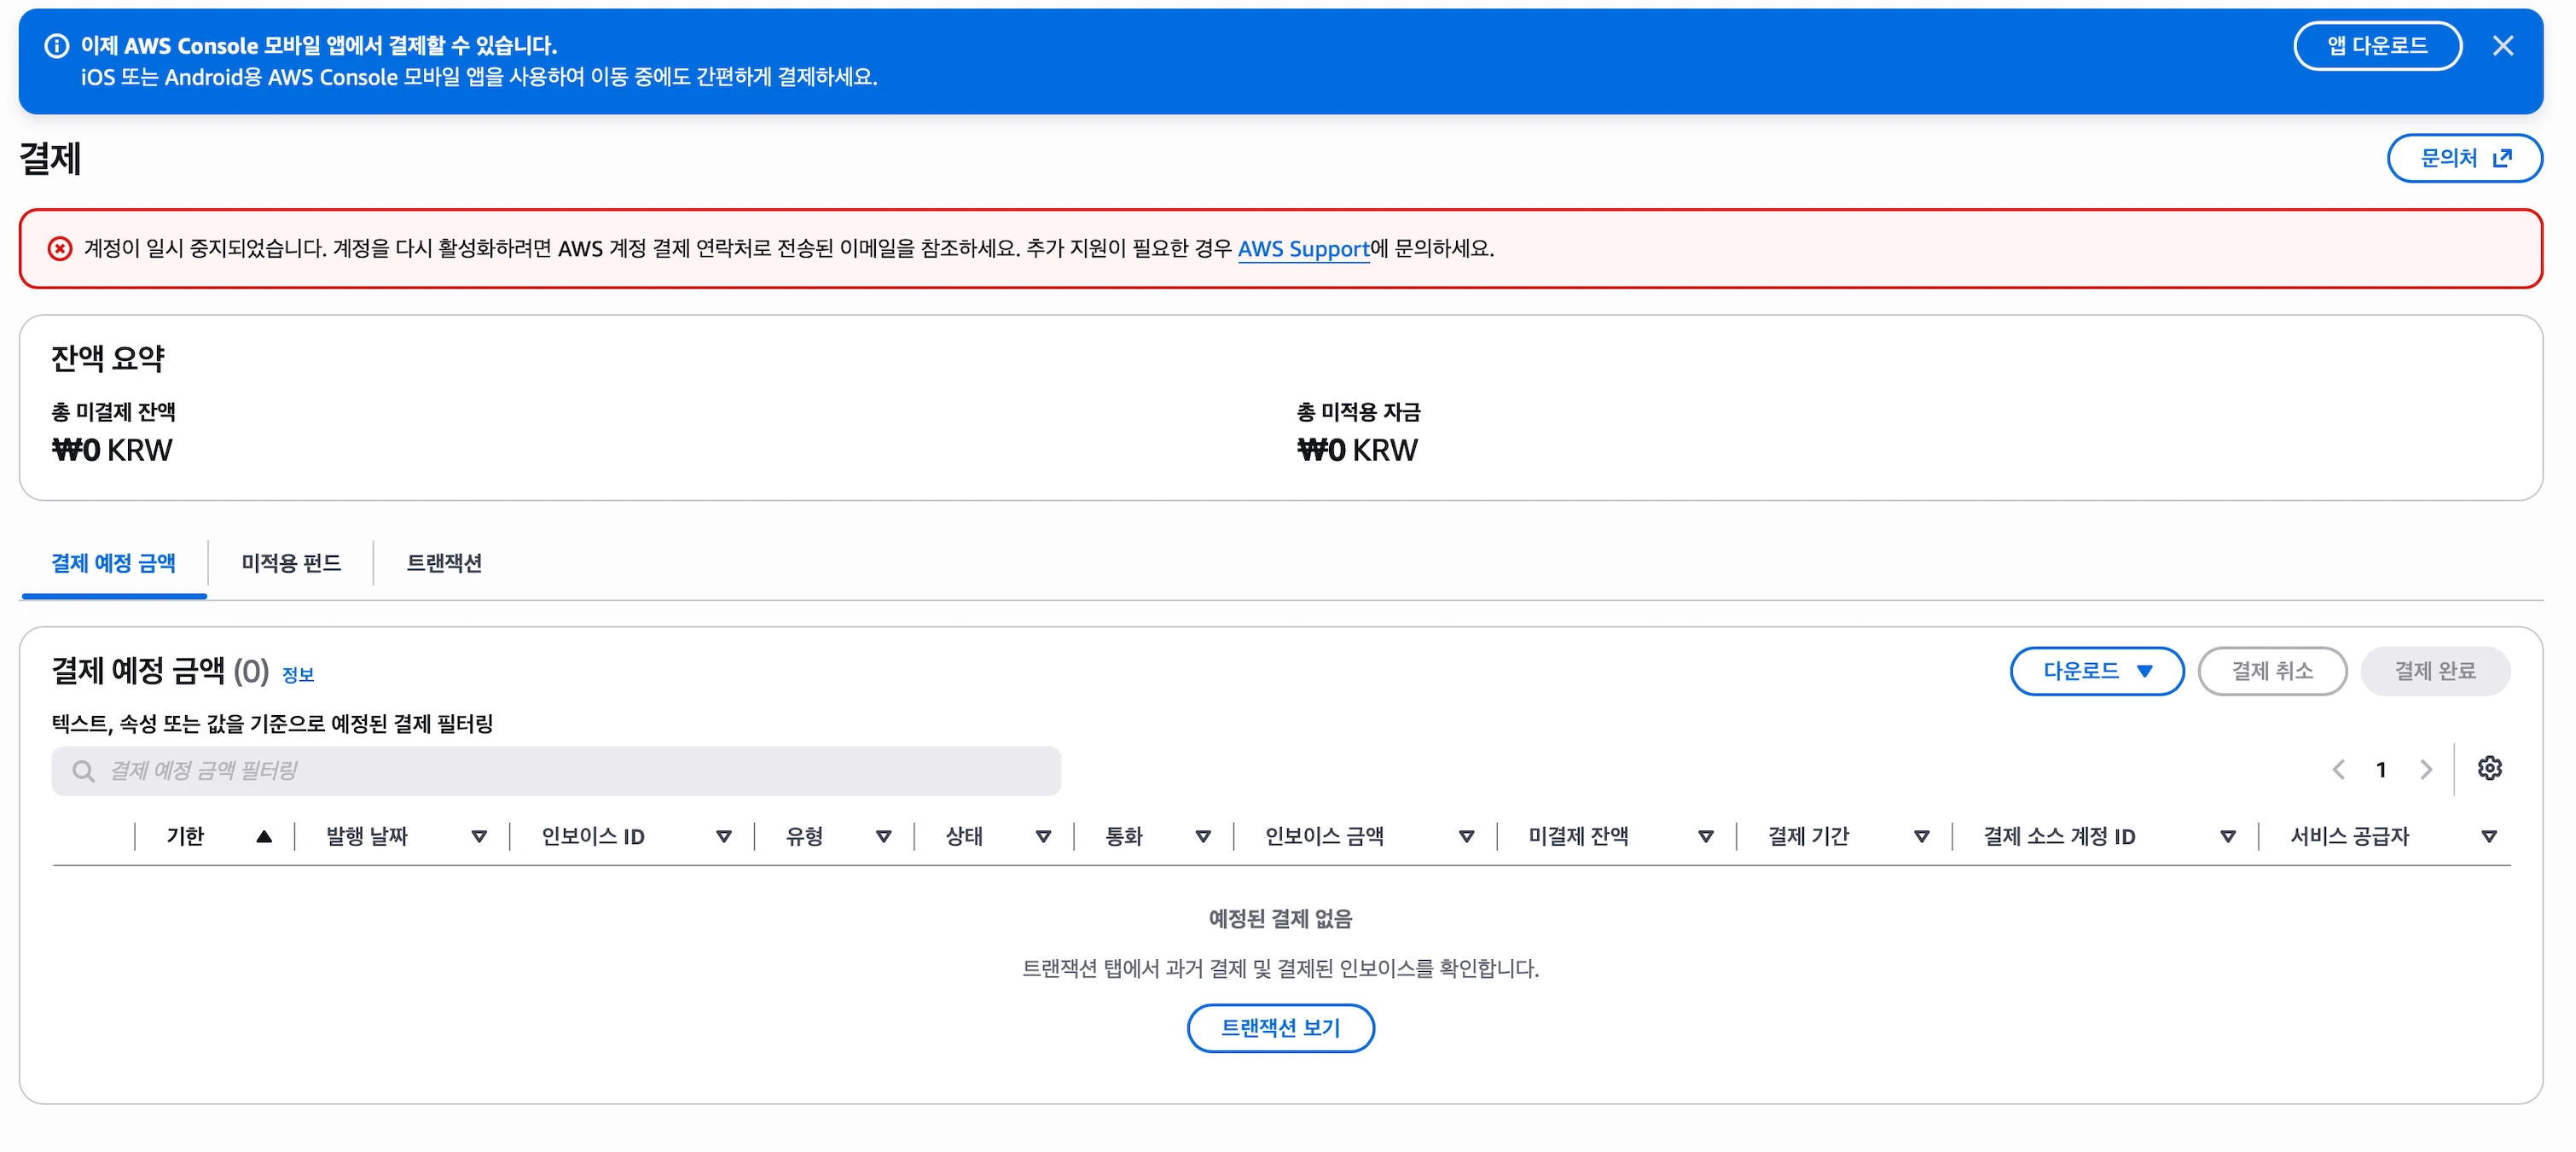
AWS에 들어가 보니 계정이 일시 중지되어 있었고, EC2 네 대도 모두 꺼져 있었다.
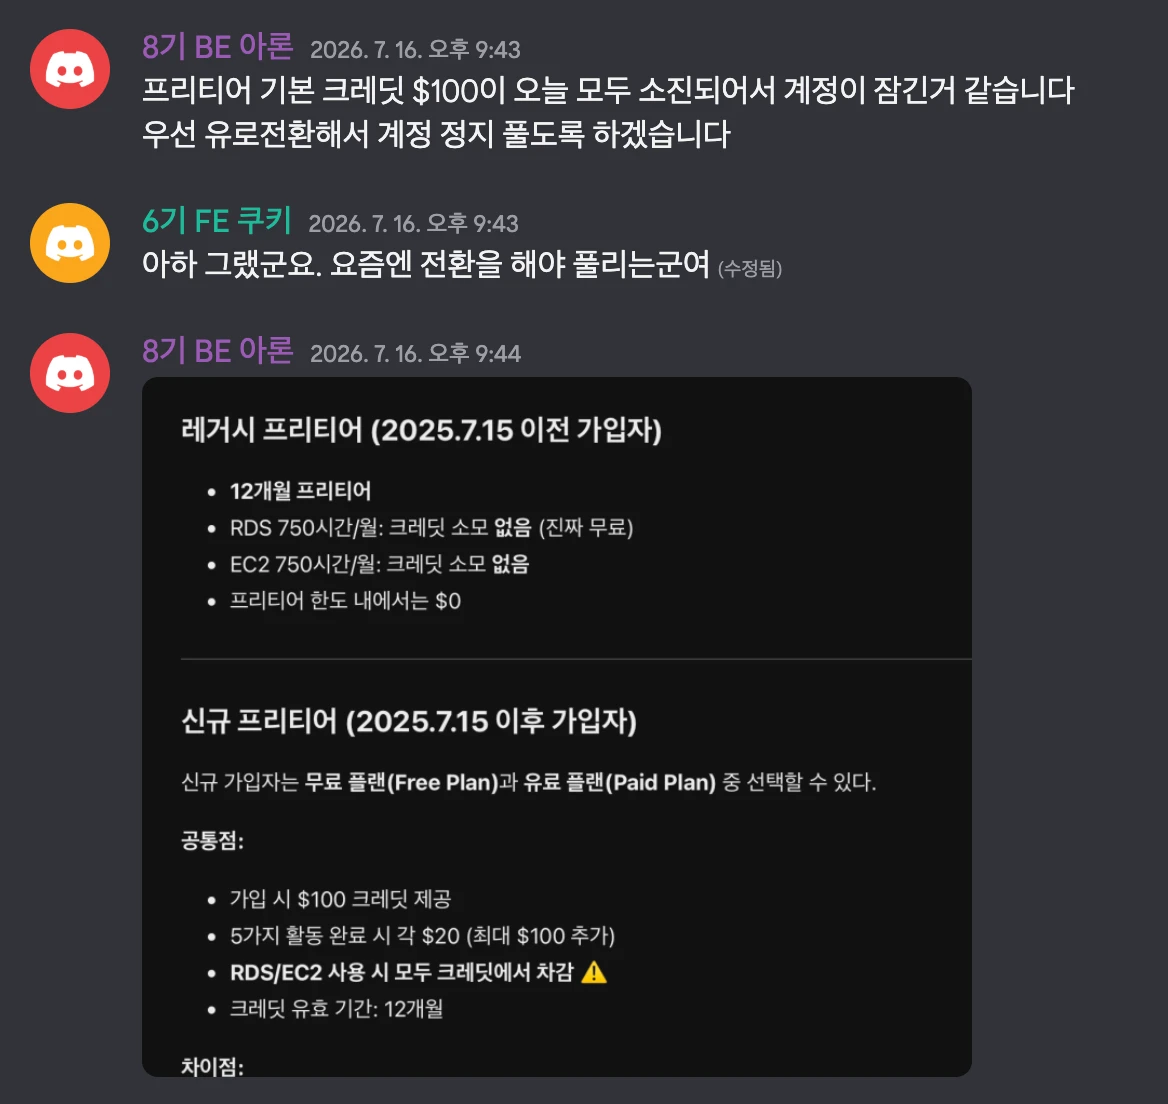
계정에 적용된 AWS 무료 플랜은 크레딧 기반이었고, 남은 크레딧은 0달러였다.
팀 계정으로 오는 비용 알림을 제대로 확인하지 못하고 있었다…
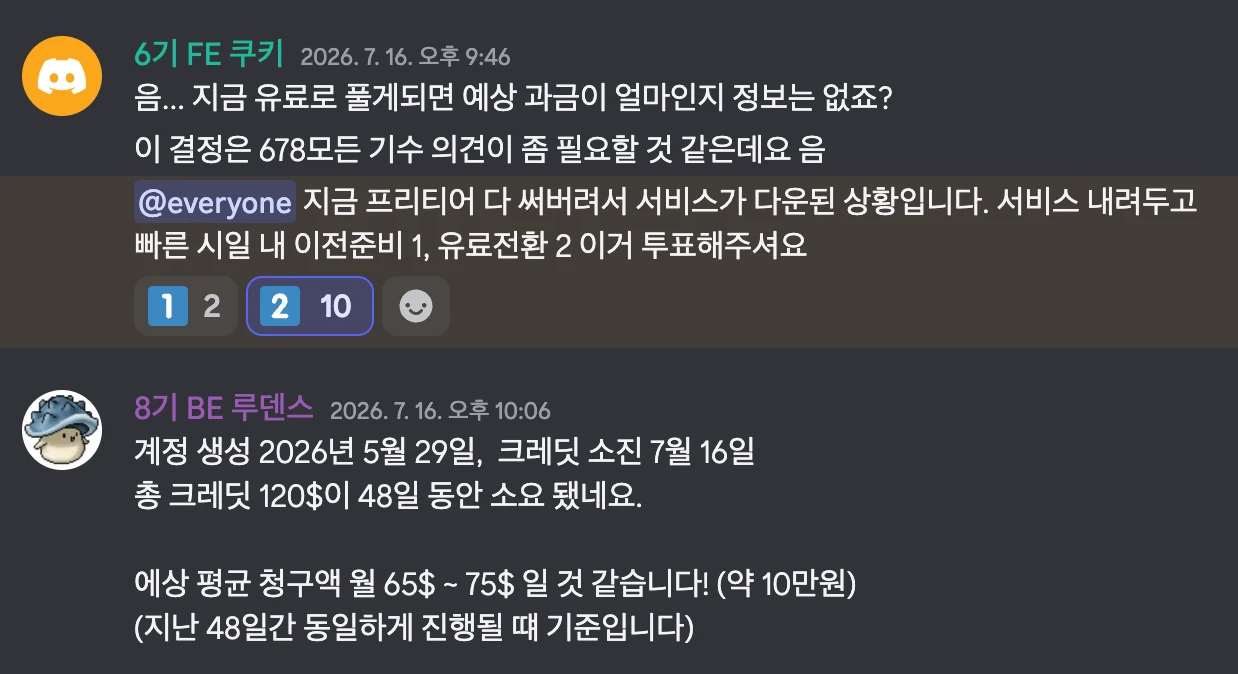
서비스를 계속 운영하려면 비용을 부담해야 했다.
팀원들에게 유료 전환 여부를 투표로 물었고, 결정하는 데 일주일 정도가 걸렸다.
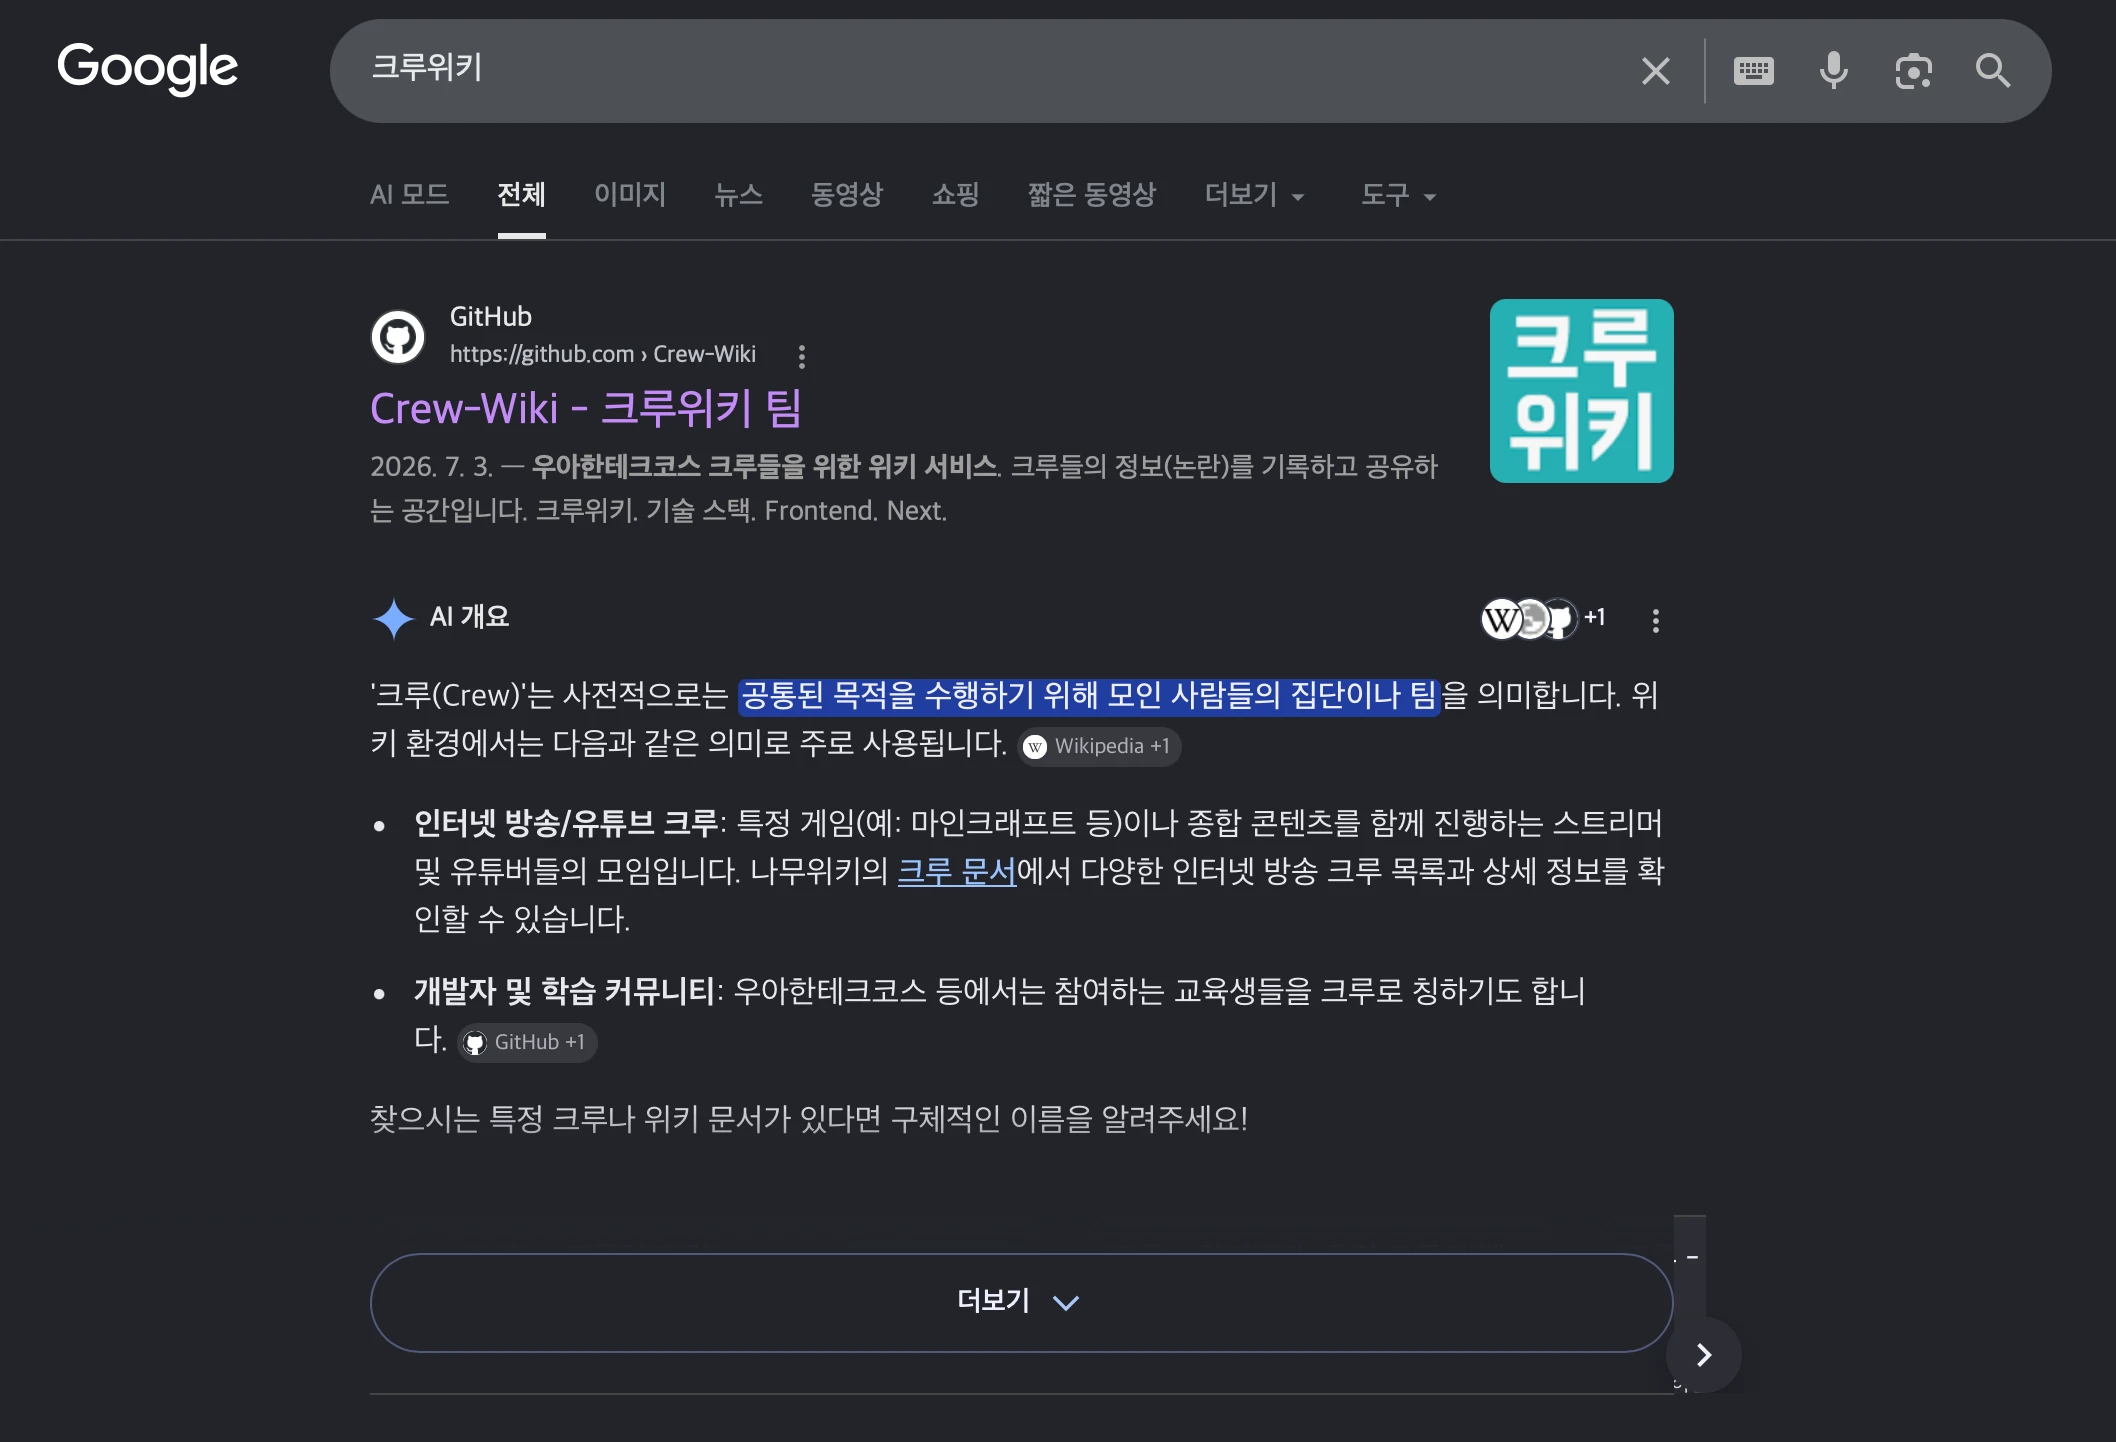
투표가 진행될 일주일 동안 서버가 꺼져있어, 크루위키가 구글에서 사라졌다..
잃어버린 데이터베이스
AWS는 유료 전환하는 것으로 결정되었고, 이제 서버를 다시 켜야했다.
하지만, EC2를 다시 켜도 서비스는 열리지 않았다.
이번에는 RDS가 문제였다.
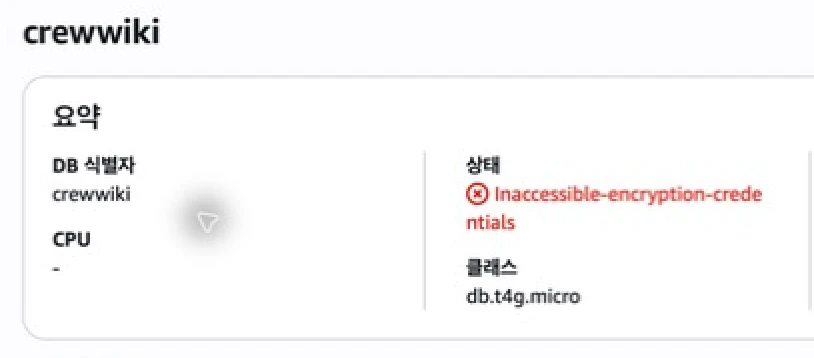
기존 DB는 Inaccessible-encryption-credentials 상태였다.
단순히 중지된 상태가 아니라, 기존 인스턴스를 다시 시작하는 방식으로는 복구할 수 없는 상태였다.
이 때 정말 식겁했다.
선배들의 데이터를 날려버렸다는 것이 너무 공포스러워서 백엔드끼리 모여서 떨었던 것이 생각난다..
정말정말정말정말다행히도
사용 가능한 스냅샷 네 개가 남아 있었다.
기존 DB를 보존한 채 스냅샷으로 복원한 새 DB를 사용했다.
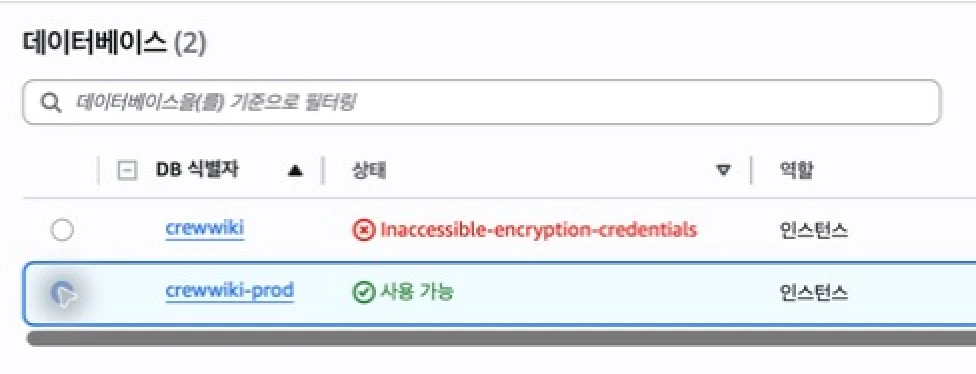
연결 설정과 배포를 바꾸기 전에는 복구 DB의 안전 스냅샷도 하나 더 남겼다.
산 넘어 산
새 DB는 available이었지만 API는 여전히 502 Bad Gateway를 반환했다.
백엔드 로그를 확인하니 다음 오류가 있었다.
running=true status=running exit_code=0 restart_count=30 error=""
character_encoding=UTF
curl: (56) Recv failure: Connection reset by peer
http_status=000
Unsupported character encoding 'UTF'
새 DB의 연결 정보를 반영하면서 JDBC URL의 인코딩 값을 잘못 넣은 것이었다.
characterEncoding=UTF위 값을 다음처럼 고쳤다.
characterEncoding=UTF-8PROD_DB_URL을 수정하고 다시 배포한 뒤에는 CrewWiki에 정상적으로 접속되는 것까지 직접 확인했다.
배운 것
이번 사전에는 자동으로 저장되어 남아 있던 스냅샷 덕분에 복구할 수 있었다.
타이밍이 맞지 않았다면, 데이터를 모두 날려버릴 수도 있었다.
스냅샷을 주기적으로 생성하는 것이 매우 중요하다는 것을 깨달았다.
추가로, 이번 일에 대처하지 못한 것은 서버 부하, 모니터링 등의 문제가 아니라 단지 메일을 확인하지 못해서였다.
이에 대해서도 확인하고 조치할 담당자를 정하고 알림 시스템을 구축하는 것이 중요하다는 것을 느꼈다.