MySQL InnoDB에서 동시에 두 요청을 다루는 법
이 글의 목차8개
MySQL InnoDB에서 같은 재고를 읽는 두 요청을 다루는 법
재고가 하나 남은 상품에 두 주문이 들어옵니다. 주문을 받는 코드는 단순합니다. 재고를 조회하고, 하나 이상 남아 있으면 수량을 줄인 뒤 주문을 저장합니다. 재고 변경과 주문 저장은 하나의 트랜잭션으로 묶습니다.
주문 저장에 실패하면 재고도 되돌릴 수 있고, 수량이 음수가 되지 않도록 제약 조건도 걸었습니다. 이 정도면 충분해 보입니다. 그런데 첫 번째 요청이 재고를 줄이기 전에 두 번째 요청도 같은 재고를 읽는다면, 두 요청은 어떤 값을 저장하게 될까요.
실제로 두 연결이 모두 재고 1을 읽도록 순서를 맞추고, 각자 계산한 0과 주문을 저장해 봤습니다. 결과는 재고 0, 주문 2건이었습니다. 수량은 음수가 아니었고 두 트랜잭션도 정상적으로 커밋됐습니다. 하지만 재고 하나로 두 주문을 받은 셈입니다.
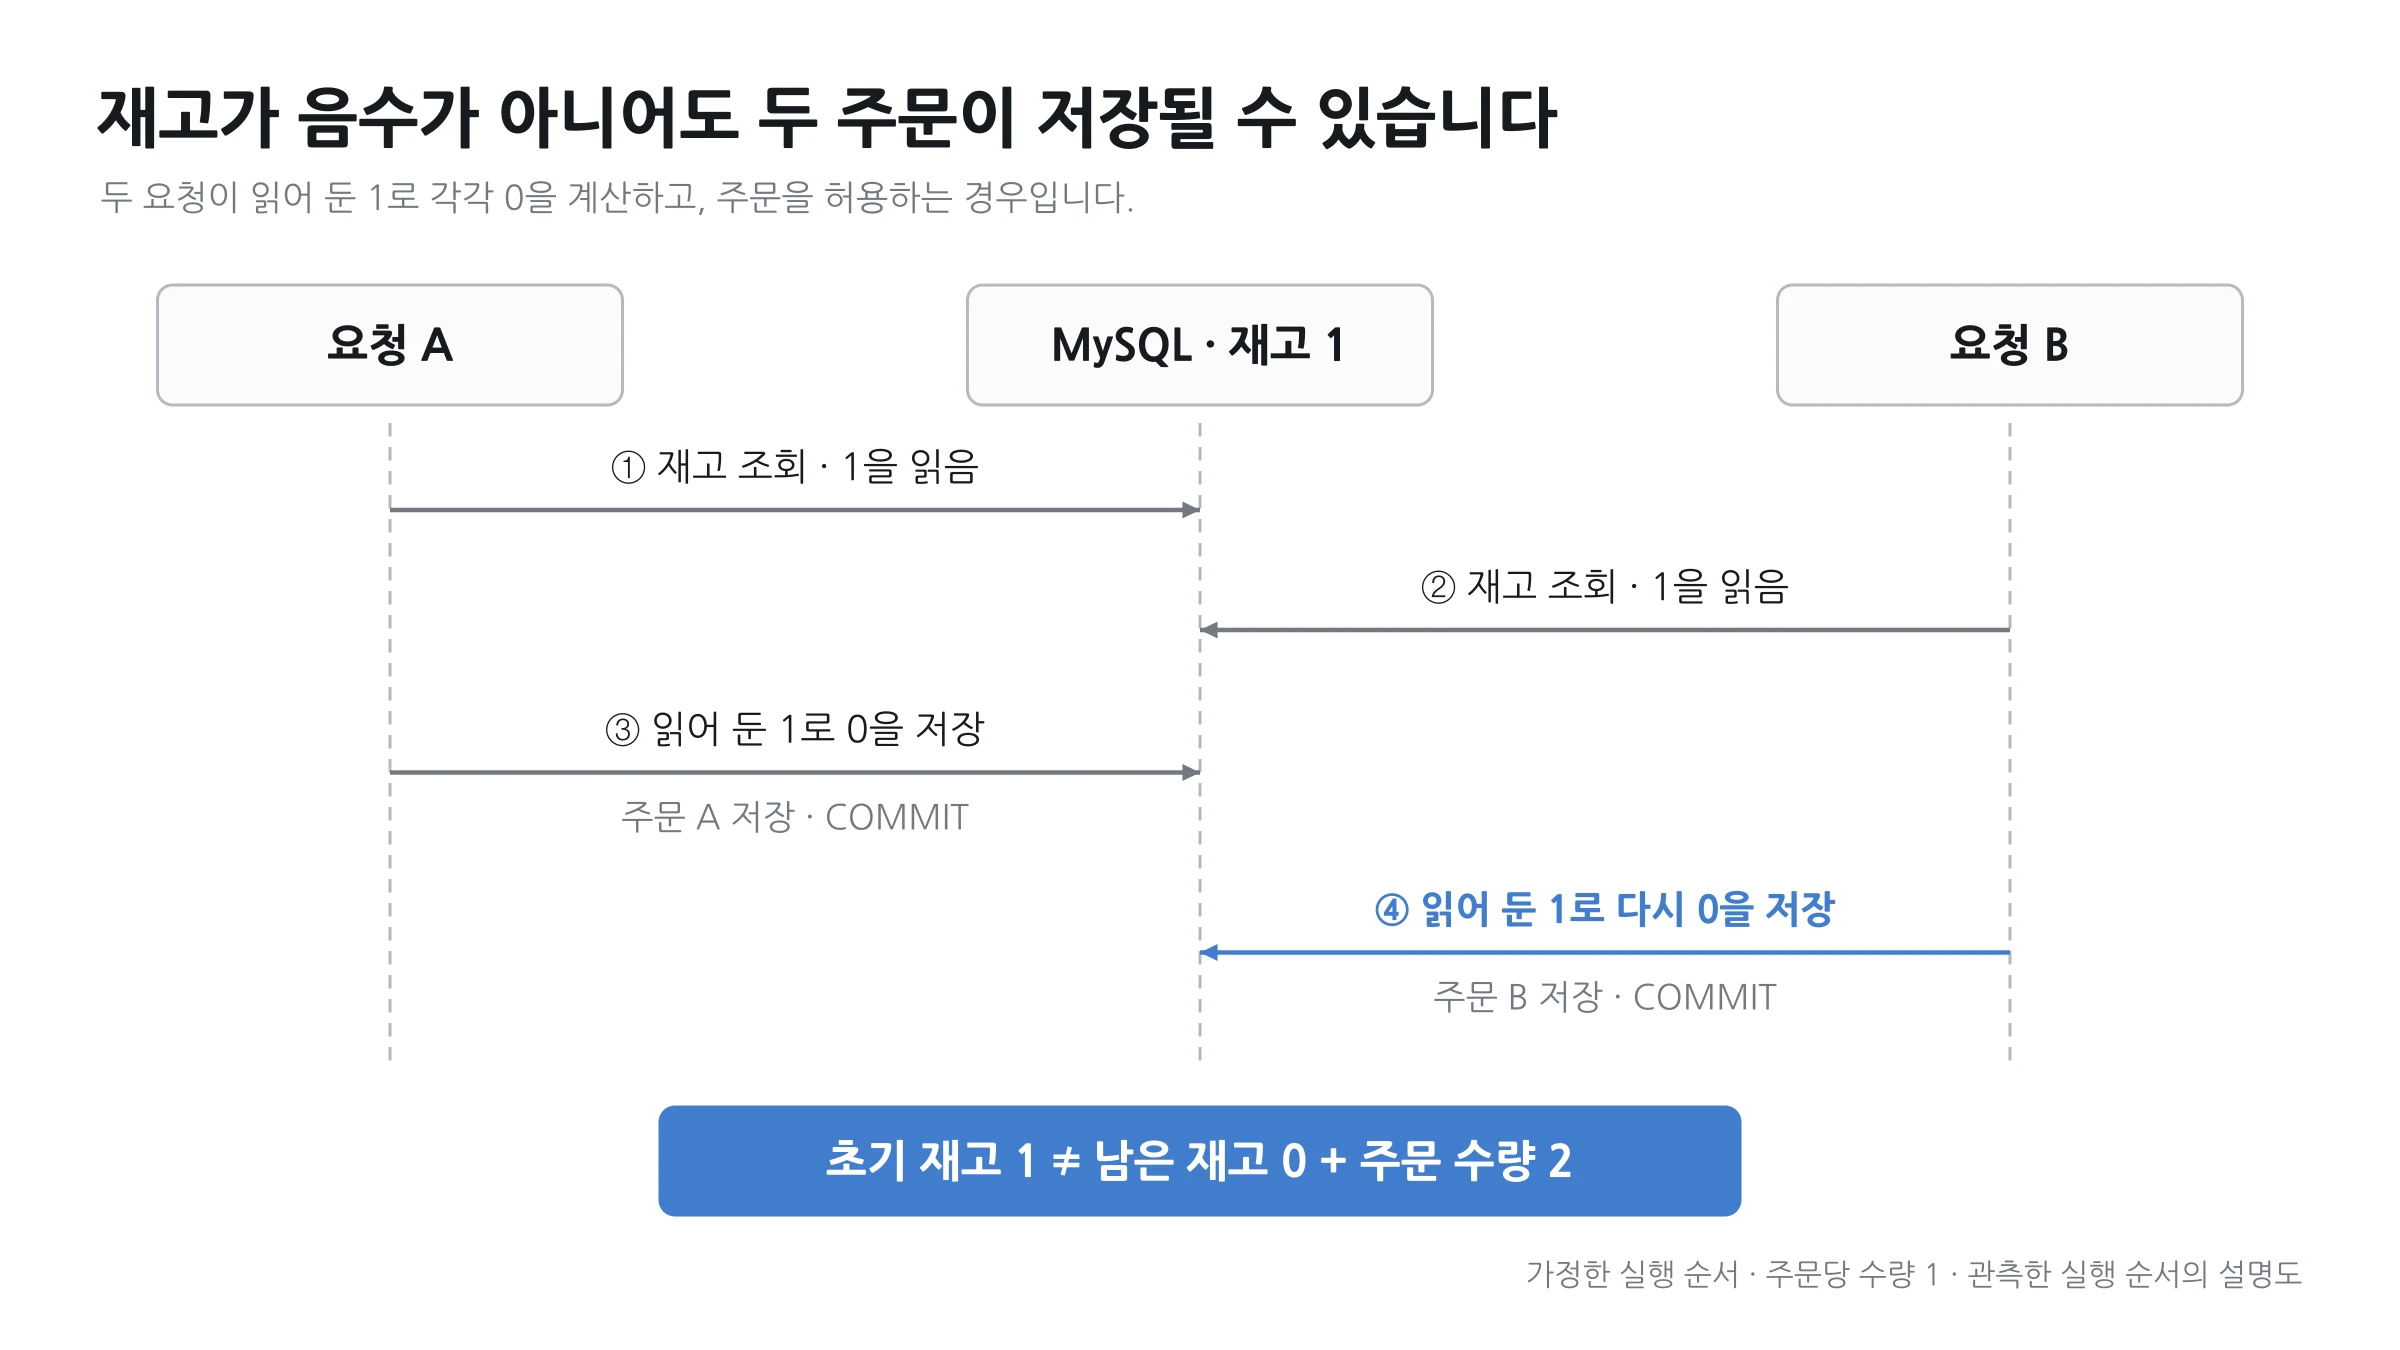
이 문제를 확인하려면 남은 수량만 봐서는 부족합니다. 재입고와 취소가 없는 이번 예시에서는 다음 관계가 유지되어야 합니다.
초기 재고 = 남은 재고 + 커밋된 주문 수량의 합이 글은 실제 서비스 장애 회고가 아니라, 이 관계를 지키는 방법을 직접 비교한 실험입니다. MySQL 8.4.13의 InnoDB에서 한 상품의 재고를 다루고, 마지막에는 두 상품 주문으로 범위를 넓힙니다. 오래된 값으로 주문을 허용하는 상황에서 시작해, 읽는 값과 잠금을 구분하고, 대기 시간과 교착 상태까지 살펴보겠습니다.
1. 함께 저장하는 것만으로는 부족
첫 실험에서는 서로 다른 DB 연결 A와 B가 트랜잭션을 시작한 뒤 재고 1을 읽었습니다. 두 연결이 모두 읽기를 마친 다음 A를 먼저 커밋하고 B를 진행했습니다. 여러 요청을 무작정 보내는 대신, 어떤 순서가 문제를 만드는지 드러내기 위한 구성입니다.
핵심은 차감 SQL에 있습니다. 처음 구현은 읽은 값을 애플리케이션 쪽에 보관한 뒤, 그 값에서 1을 뺀 결과를 DB에 보냈습니다. 실험에서는 연결별 사용자 변수로 같은 동작을 만들었습니다.
-- A와 B가 각각 실행해 모두 1을 읽습니다.
START TRANSACTION;
SELECT quantity INTO @stock FROM products WHERE id = 1;

-- A가 아래 내용을 먼저 끝내고, 그다음 B가 진행합니다.
UPDATE products SET quantity = @stock - 1 WHERE id = 1;
-- 각 요청은 서로 다른 주문 ID로 주문을 저장합니다.
COMMIT;
B의 UPDATE가 실행될 때 실제 재고는 이미 0입니다. 하지만 @stock에는 처음 읽은 1이 남아 있습니다. B는 DB의 현재 수량에서 1을 빼는 대신, 이전 값으로 계산한 0을 다시 저장합니다. 이때 변경된 행 수는 0이었지만, 실패 구현은 이를 검사하지 않고 주문을 저장했습니다.
| 격리 수준 | A/B가 읽은 값 | 최종 재고 | 주문 수량 합 |
|---|---|---|---|
| REPEATABLE READ | 1 / 1 | 0 | 2 |
| READ COMMITTED | 1 / 1 | 0 | 2 |
쓰기 자체에도 잠금이 사용됩니다. 그렇다고 B가 앞서 내린 주문 허용 판단까지 자동으로 다시 수행되는 것은 아닙니다. 이번에는 두 UPDATE를 겹쳐 실행할 필요도 없었습니다. 두 요청의 읽기가 첫 수정보다 먼저 끝나는 순서만으로 문제가 생겼습니다.
그렇다고 트랜잭션이 필요 없어진 것은 아닙니다. 별도 실험에서 재고 차감 직후 ROLLBACK을 실행하자, A에게 0으로 보이던 재고가 다른 연결에서는 다시 1로 확인됐습니다. 트랜잭션은 함께 저장하거나 함께 취소할 변경의 범위를 정합니다. 여기에 경쟁하는 요청이 어떤 값을 근거로 판단할지도 정해야 했습니다. COMMIT과 ROLLBACK
READ COMMITTED로 바꾼 실험도 결과는 같았습니다. B가 이미 보관한 값을 다시 사용하기 때문입니다. 그러면 수정 전에 재고를 다시 조회하면 충분할까요. 먼저 InnoDB에서 다시 읽는다는 것이 무엇을 의미하는지 확인할 필요가 있습니다.
2. 다시 읽는다고 항상 새로운 재고가 보이지 않는다
A가 재고 1을 읽은 뒤, B가 재고를 0으로 바꾸고 커밋하도록 했습니다. 그다음 A가 일반 SELECT를 한 번 더 실행했습니다. 기본 격리 수준인 REPEATABLE READ에서는 여전히 1이 보였습니다. 같은 연결에서 FOR UPDATE를 붙이자 이번에는 0이 나왔습니다.
| A의 격리 수준 | 최초 일반 조회 | B 커밋 후 일반 조회 | B 커밋 후 잠금 조회 |
|---|---|---|---|
| REPEATABLE READ | 1 | 1 | 0 |
| READ COMMITTED | 1 | 0 | 0 |
이 차이를 이해하려면 ‘현재 저장된 값’과 ‘이번 읽기에 보이는 값’을 구분해야 합니다. InnoDB는 변경 이전의 행을 재구성할 수 있도록 undo 정보를 보관합니다. 읽기 시점의 가시성 규칙에 맞는 버전을 제공하는 방식이 MVCC, 즉 다중 버전 동시성 제어입니다. 트랜잭션마다 DB 전체를 복사해 두는 것은 아닙니다. InnoDB Multi-Versioning
REPEATABLE READ의 일반적인 일관 읽기는 첫 번째 일관 읽기가 정한 스냅샷을 이어서 사용합니다. A가 읽기를 시작한 뒤 B가 커밋했으므로, 두 번째 일반 조회에도 이전 재고 1이 보입니다. READ COMMITTED에서는 문장마다 새로운 스냅샷을 사용해 두 번째 조회에서 0이 보였습니다. 이 실험에서 A 자신은 데이터를 수정하지 않았습니다. Consistent Nonlocking Reads
같은 트랜잭션에서 일관된 값을 읽을 수 있다는 것은 유용합니다. 여러 번 조회하는 동안 다른 요청의 수정이 계속 섞이면, 하나의 기준으로 데이터를 해석하기 어려울 수 있기 때문입니다. 다만 내가 읽은 재고가 보인다는 사실이 그 재고를 내 주문에 예약했다는 뜻은 아닙니다. 다른 요청도 그 상품을 수정할 수 있습니다.
잠금 읽기는 용도가 다릅니다. 이번 실험에서는 B가 이미 커밋한 뒤였으므로 FOR UPDATE가 재고 0을 읽었습니다. 주문을 위해 수정할 행을 읽고 보호하는 동작을, 이전 스냅샷을 반복해서 읽는 동작과 같은 것으로 보면 이 결과를 설명하기 어렵습니다.
READ COMMITTED에서 새 값이 보였다는 이유만으로 조회와 수정 사이의 틈이 사라지는 것도 아닙니다. 조회가 끝난 다음 다른 요청이 재고를 가져갈 수 있습니다. 필요한 것은 조회 횟수를 늘리는 데서 한 걸음 더 나아가, 재고를 확인하고 주문을 허용하는 구간에 다른 수정이 끼어드는 것을 다루는 방법입니다.
3. 재고를 판단하는 동안 다음 수정을 대기
앞선 문제는 두 요청이 같은 재고 1을 읽고, 각자 주문을 받아도 된다고 판단했다는 데 있습니다. 따라서 먼저 재고를 확인한 요청이 주문을 저장할 때까지, 같은 상품을 수정하려는 다른 요청이 그 사이에 끼어들지 못하게 해야 합니다.
FOR UPDATE는 수정할 행을 읽으면서 잠금을 획득합니다. A가 잠금을 유지하면 B의 잠금 읽기는 기다리므로, B는 A의 처리가 끝난 뒤 재고를 확인하게 됩니다. 실험에서도 A가 재고 1을 읽고 트랜잭션을 유지하자, 같은 상품을 읽으려는 B의 FOR UPDATE가 바로 반환되지 않았습니다.
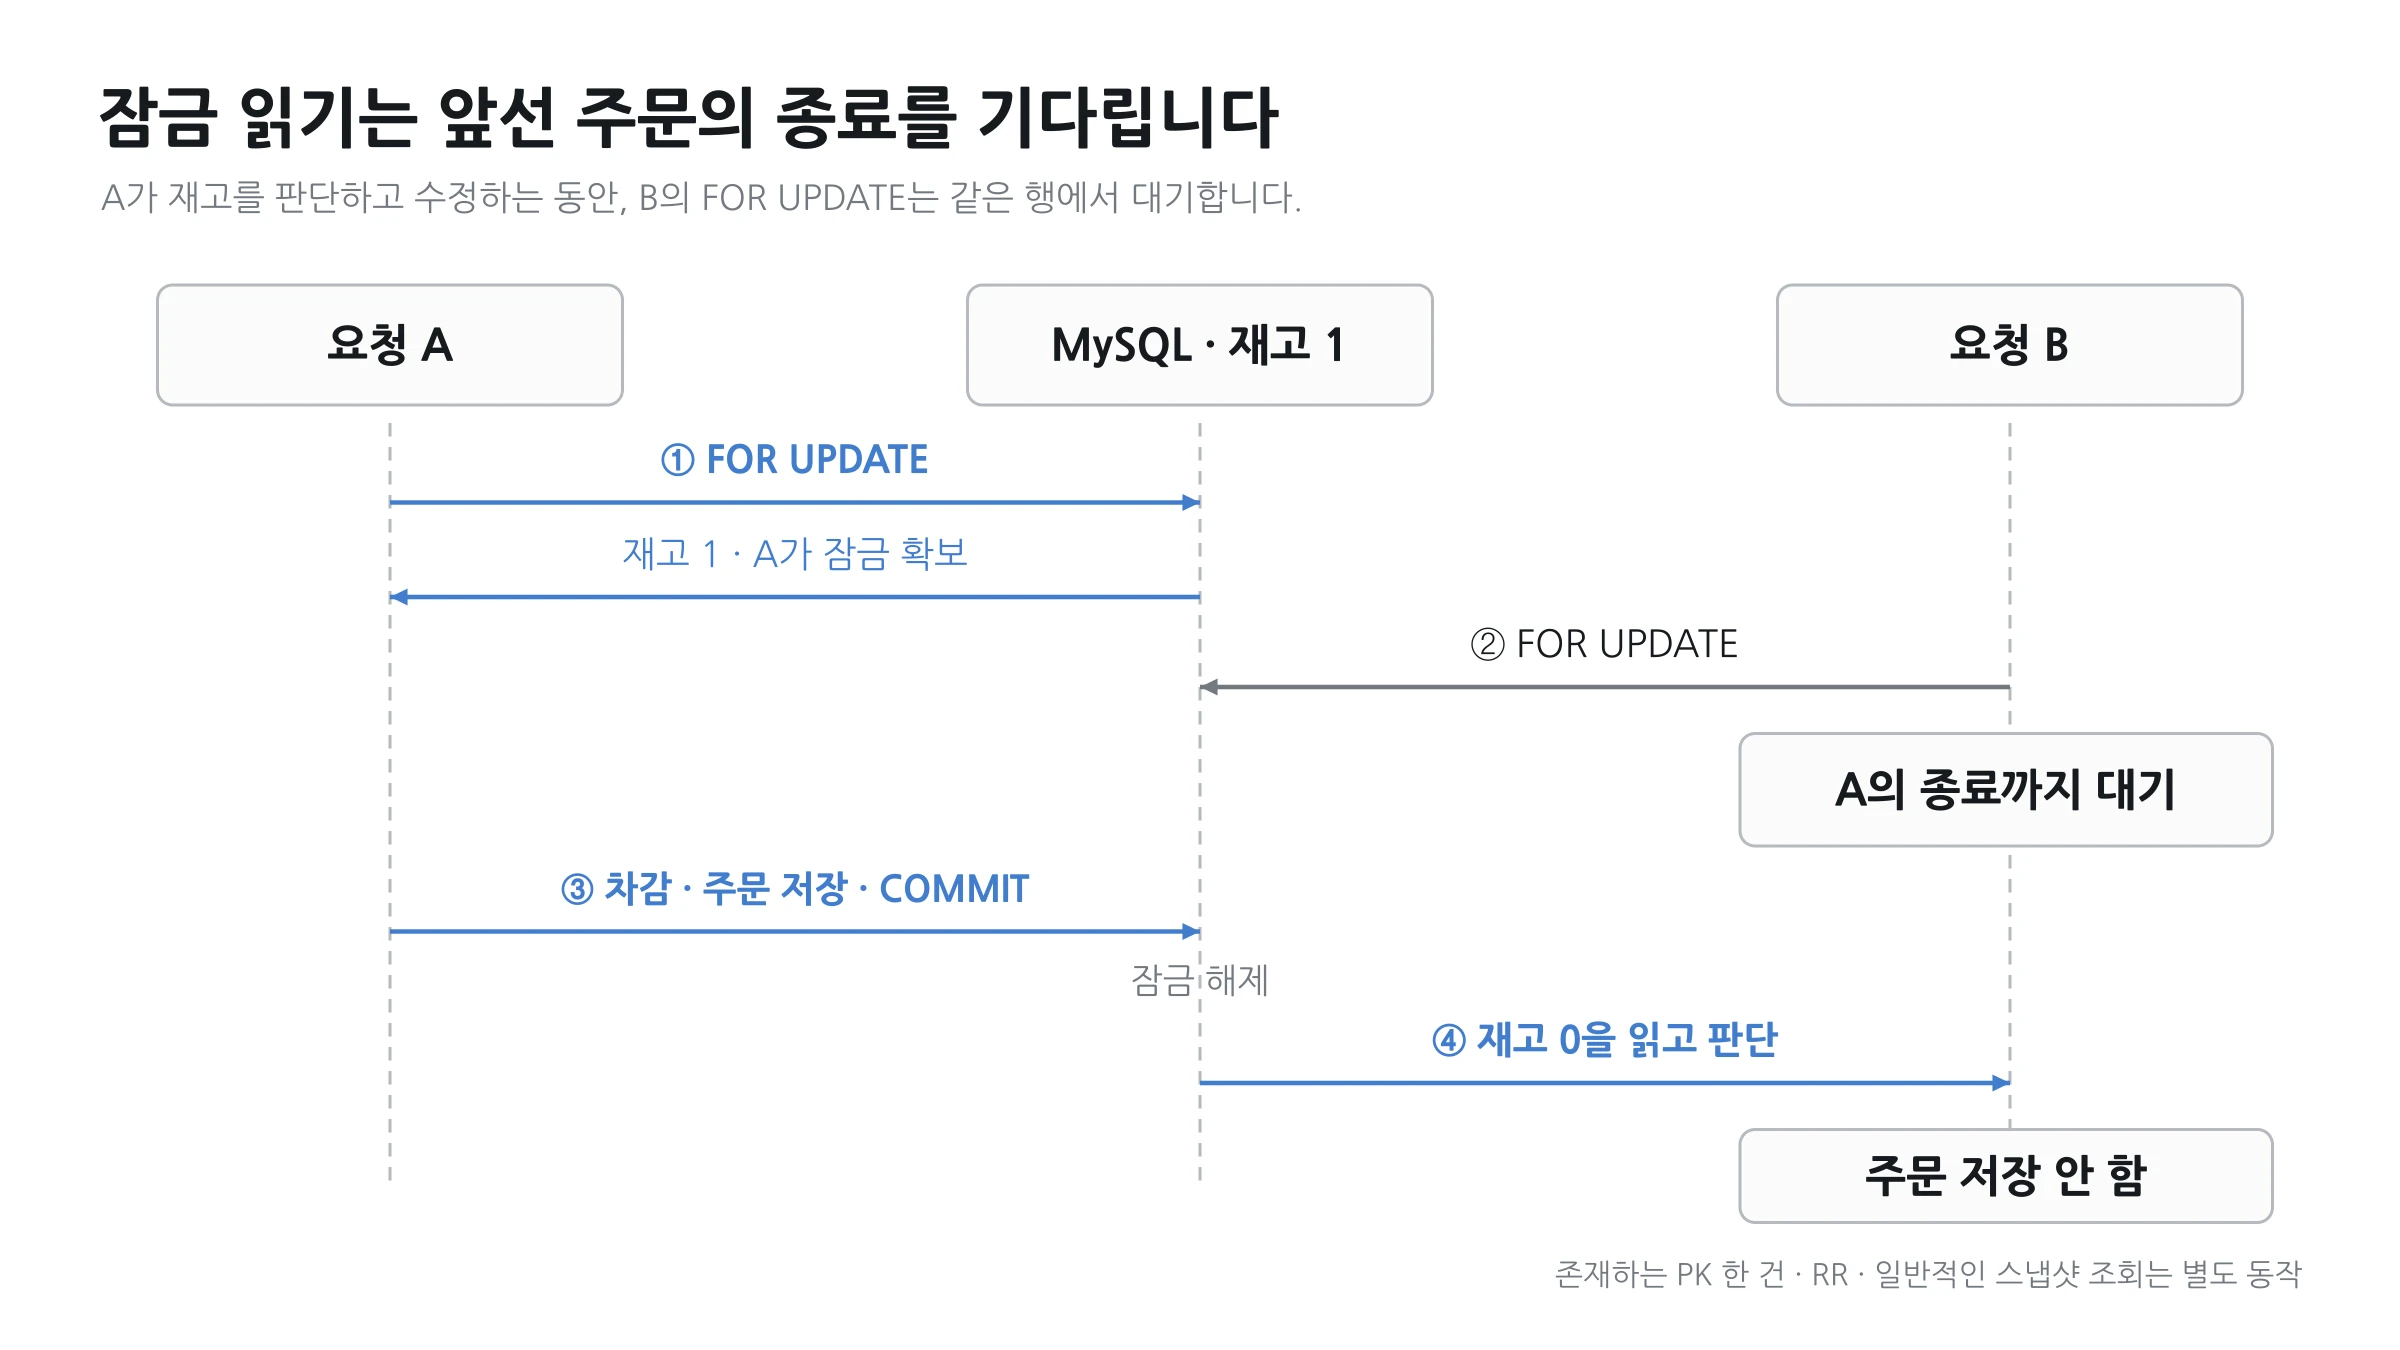
응답이 늦다는 사실만으로 잠금 대기라고 판단하지는 않았습니다. 관찰용 연결 C에서 performance_schema.data_locks와 data_lock_waits를 조회했습니다. 상품의 PRIMARY 인덱스 키 1에 대해 A는 X,REC_NOT_GAP 잠금을 획득했고, B는 같은 모드의 잠금을 기다리고 있었습니다.
| 요청 | 대상 | 상태 |
|---|---|---|
| A | 상품 1의 PRIMARY 레코드 | GRANTED |
| B | 상품 1의 PRIMARY 레코드 | WAITING |
A가 재고를 차감하고 주문을 저장한 뒤 커밋하자 B의 조회가 끝났습니다. B가 읽은 값은 0이었고, 주문을 저장하지 않도록 처리한 결과 재고 0·주문 1건이 남았습니다. 읽기 시점부터 판단에 필요한 행을 보호한 것이 첫 구현과의 차이입니다.
A가 조회 결과를 받았다고 잠금이 풀리지는 않습니다. 재고를 읽은 뒤 주문을 저장하기까지 보호하려면, 그 사이에도 잠금이 유지되어야 하기 때문입니다. 이번 명시적 트랜잭션에서 획득한 잠금은 COMMIT이나 ROLLBACK까지 유지됩니다. Locking Reads
반면 C의 일반 SELECT는 A가 끝나기를 기다리지 않고 재고 1을 반환했습니다. C는 수정할 행의 잠금을 얻으려는 것이 아니라, MVCC를 통해 자신에게 보이는 커밋된 버전을 읽기 때문입니다. 앞 절의 스냅샷 읽기가 여기서도 동작한 셈입니다.
여기서 확인한 것은 이미 존재하는 기본 키 한 건입니다. 유일 키를 정확히 찾을 때의 레코드 잠금과 달리, 범위를 탐색하는 쿼리에는 빈 구간의 삽입을 제한하는 갭 잠금이나 레코드와 앞 구간을 함께 보호하는 넥스트키 잠금이 관여할 수 있습니다. 잠금 범위를 판단할 때는 결과 행 수뿐 아니라 인덱스와 실제 접근 경로도 살펴봐야 합니다. SQL별 잠금 범위
4. 확인과 차감을 한 문장에
이번 주문의 판단은 단순합니다. 재고가 하나 이상이면 하나 줄이면 됩니다. 그렇다면 애플리케이션이 값을 읽고 비교하는 대신, 그 조건을 수정 SQL에 넣을 수 있습니다.
UPDATE products
SET quantity = quantity - 1
WHERE id = 1 AND quantity >= 1;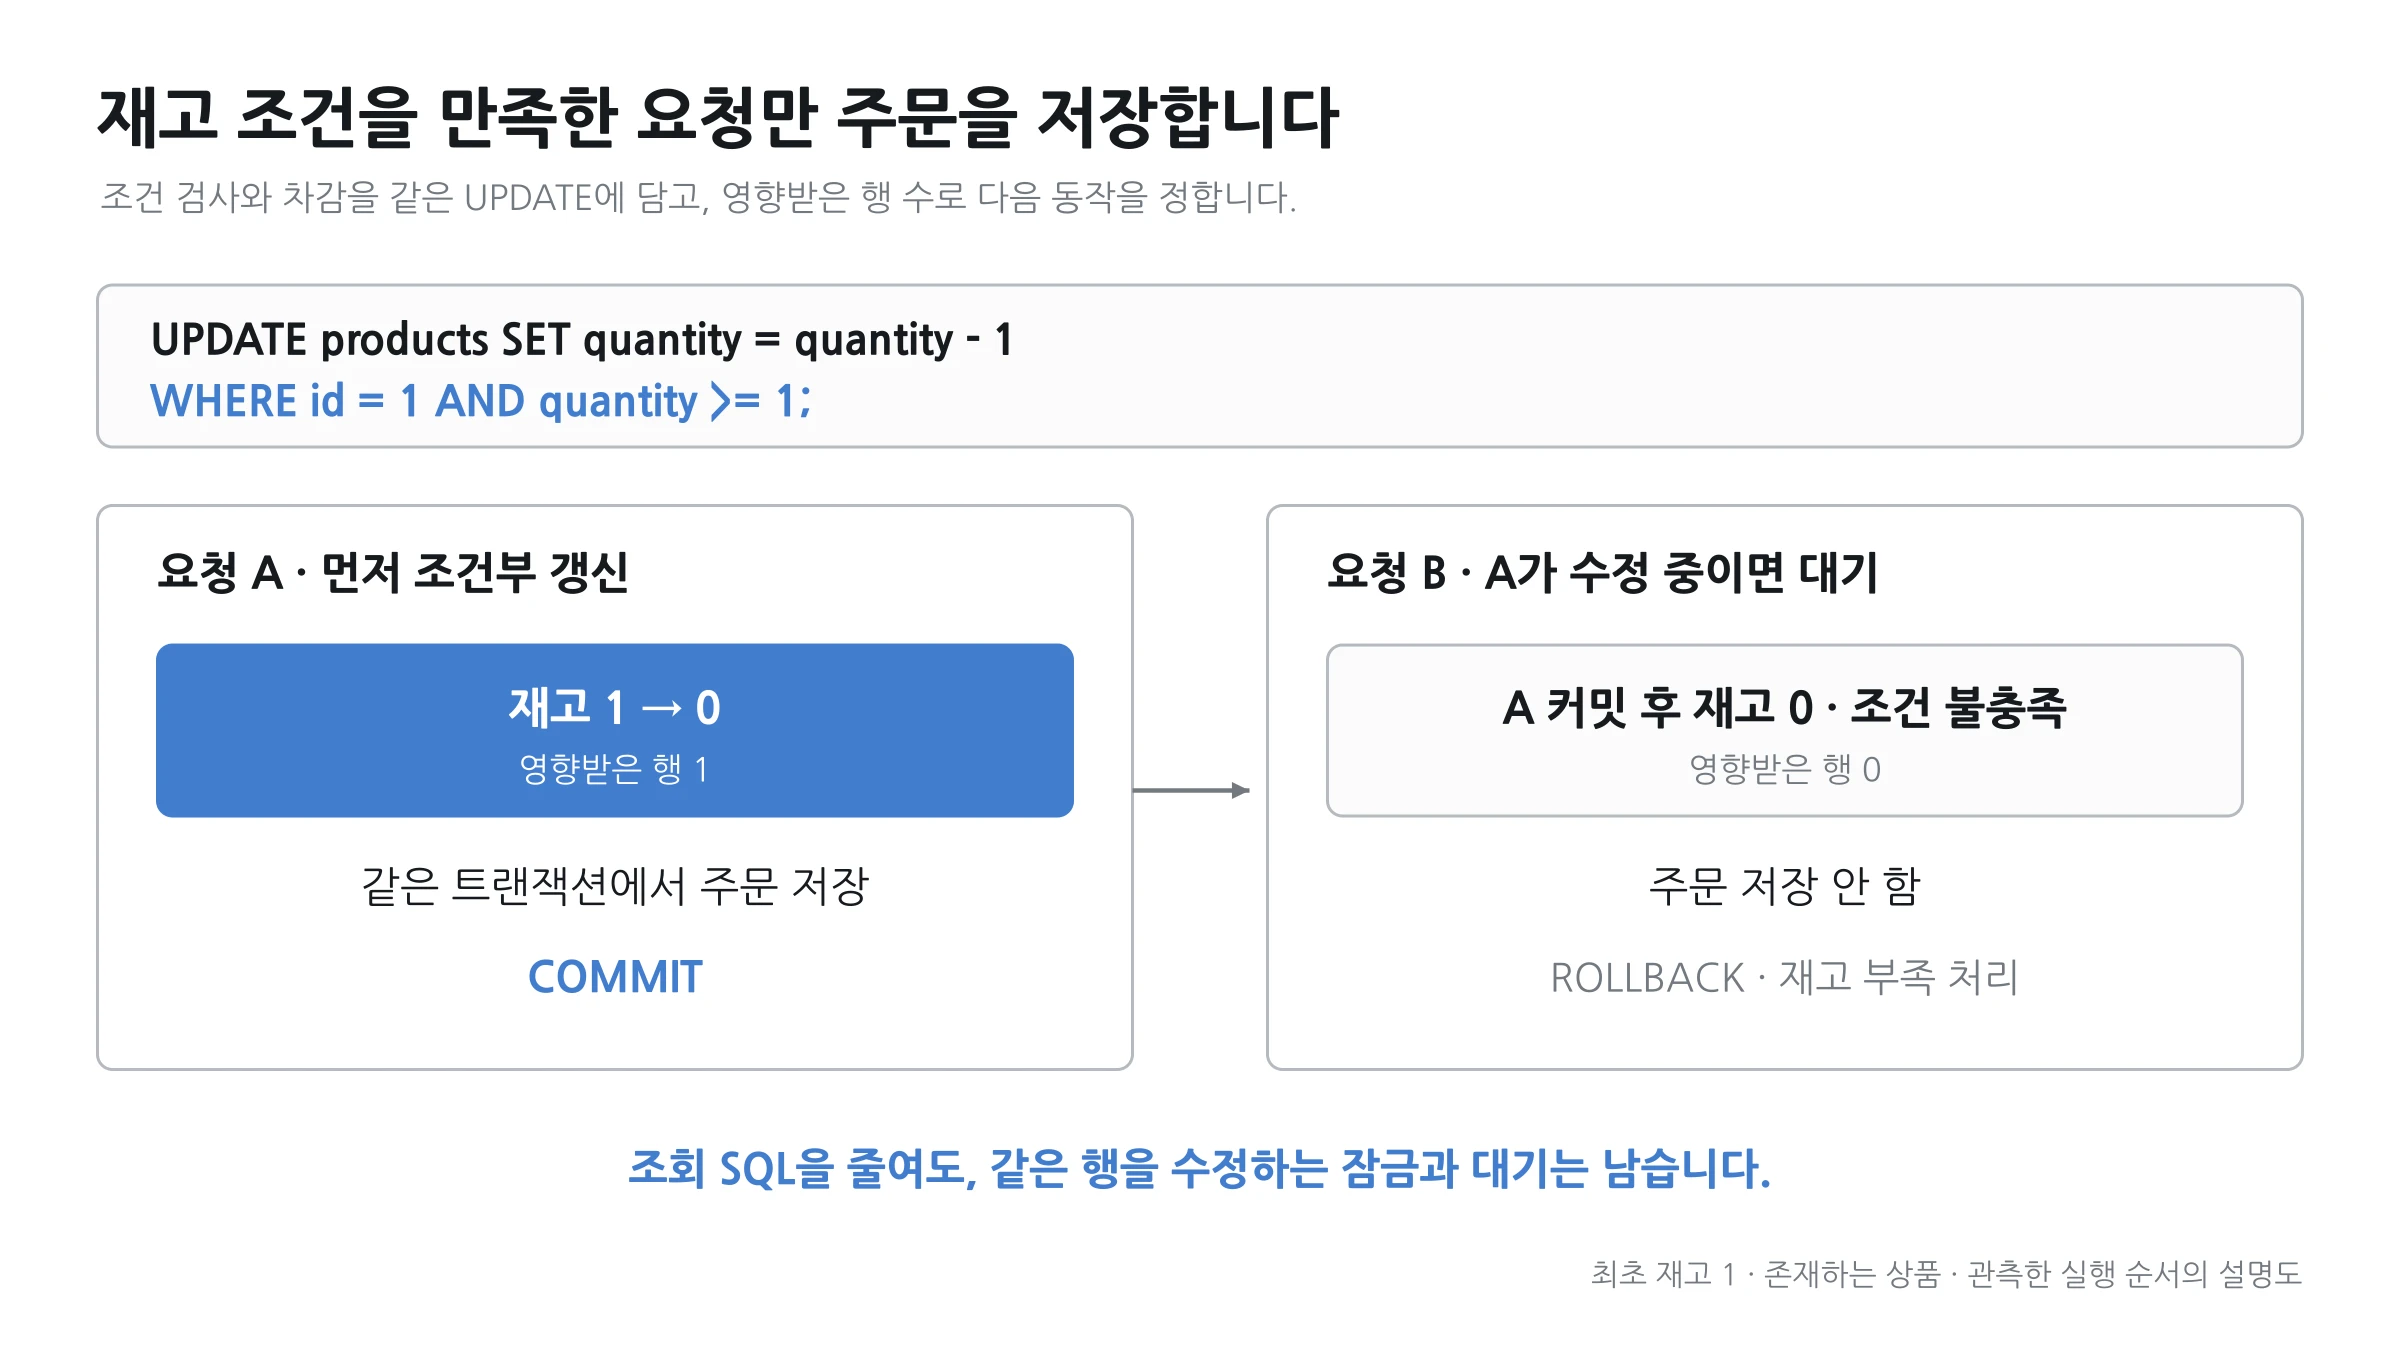
A의 UPDATE는 1행을 변경했습니다. 아직 커밋하지 않은 상태에서 B도 실행하자, 이번에는 B의 UPDATE가 기다렸습니다. A가 주문까지 저장하고 커밋한 뒤 B가 반환한 값은 0행이었습니다. 재고가 0이 되어 quantity >= 1 조건을 만족하지 않기 때문입니다.
영향받은 행 수가 1일 때만 주문을 저장하면, 오래된 조회값으로 주문을 허용하지 않아도 됩니다. 이 실험에서 상품은 이미 존재합니다. 그 전제가 없다면 0행에는 재고 부족뿐 아니라 상품이 없다는 의미도 포함됩니다.
조회 SQL이 줄었지만 잠금은 남았습니다. 두 요청의 UPDATE도 같은 행을 수정하므로 충돌할 수 있습니다. 조건부 갱신을 ‘잠금을 쓰지 않는 방법’이라고 설명하면 실제 관측과 맞지 않습니다. 바뀐 것은 주문을 허용하는 근거를 조회값에서 갱신 성공 여부로 옮겼다는 점입니다.
재고 차감과 주문 저장은 여전히 같은 트랜잭션이어야 합니다. UPDATE가 성공한 뒤 주문 저장이 실패했는데 재고만 남으면 다른 불일치가 생깁니다. 차감 뒤 ROLLBACK을 실행했을 때 재고 1·주문 0으로 돌아오는 것까지 확인한 이유입니다.
두 요청의 순서를 통제한 실험에 이어, 재고 100개에 주문 1,000건을 동시 작업자 16개로 보냈습니다. 두 방식 모두 3회씩 성공 100건·재고 부족 900건·DB 오류 0건을 기록했습니다. 매번 최종 재고는 0이었고 주문과 재고의 관계도 맞았습니다. 이제는 두 방식이 이 조건에서 안전하게 동작한다는 근거를 갖고, 처리 비용을 비교할 수 있습니다.
5. 같은 상품에 요청이 몰리면 두 방식 모두 대기
조건부 갱신은 재고 조회 한 번을 줄입니다. 그렇다면 동시에 주문을 보내는 작업자를 늘렸을 때도 처리량이 그만큼 늘어날까요? 같은 상품을 수정하는 요청은 여전히 앞선 트랜잭션을 기다릴 수 있으므로, SQL 수를 줄인 효과와 한 행에 요청이 몰리는 문제를 함께 살펴봐야 합니다.
그래서 한 상품에 요청을 집중한 경우와 100개 상품에 고르게 나눈 경우를 비교했습니다. 같은 행을 두고 경쟁하는 상황과 서로 다른 행을 수정할 수 있는 상황을 나누기 위해서입니다. 동시 작업자는 1개와 16개로 바꾸되, 두 구현의 주문 저장 방식과 트랜잭션 경계는 같게 유지했습니다.
비교할 지표는 초당 성공한 주문 수와 요청 지연 p95입니다. p95는 측정한 요청의 95%가 그 시간 이내에 끝났다는 뜻입니다. 처리량이 늘어도 일부 요청이 오래 기다릴 수 있으므로 두 값을 함께 봅니다. 아래 표에는 각각 3회 측정값의 중앙값을 적었습니다. p95 역시 실행별 p95의 중앙값이며, 모든 실행의 요청을 합쳐 계산한 값은 아닙니다.
초당 성공한 주문 수 — 높을수록 같은 시간에 더 많은 주문을 처리합니다.
| 상품 수 | 동시 작업자 | FOR UPDATE (건/s) | 조건부 UPDATE (건/s) |
|---|---|---|---|
| 1 | 1 | 363.8 | 442.6 |
| 1 | 16 | 449.9 | 543.3 |
| 100 | 1 | 362.6 | 424.5 |
| 100 | 16 | 1,727.4 | 2,158.8 |
요청 지연 p95 — 낮을수록 요청이 더 짧은 시간 안에 끝납니다.
| 상품 수 | 동시 작업자 | FOR UPDATE (ms) | 조건부 UPDATE (ms) |
|---|---|---|---|
| 1 | 1 | 4.36 | 3.63 |
| 1 | 16 | 43.73 | 36.73 |
| 100 | 1 | 4.29 | 3.83 |
| 100 | 16 | 12.01 | 9.52 |
재고 부족으로 빨리 끝나는 요청이 처리량에 섞이지 않도록 상품마다 재고를 충분히 두었습니다. 각 조건은 500건 워밍업 후 초기화해 2,000건을 측정했고, 두 구현의 실행 순서를 번갈아 3회 반복했습니다. 지연은 BEGIN 직전부터 COMMIT까지로, 연결 생성·커넥션 풀·HTTP 대기는 제외했습니다. 측정 24회의 요청 48,000건이 모두 커밋됐으며 DB 오류와 재고 불일치는 없었습니다.
이 환경에서는 조건부 갱신의 처리량이 더 높고 요청 지연도 낮았습니다. 그러나 두 방식 모두 한 상품에 16개 작업자를 보냈을 때는 대기가 길어졌습니다. 조건부 갱신도 작업자 1개에서 약 443건/s, 16개에서 약 543건/s였고, p95는 3.63ms에서 36.73ms로 늘었습니다.
같은 16개 작업자가 100개 상품을 나눠 처리하면 조건부 갱신은 약 2,159건/s, 잠금 읽기는 약 1,727건/s였습니다. 여러 상품으로 나누어도 클라이언트와 서버 비용은 남지만, 같은 행의 수정을 기다리는 집중 경합을 줄일 수 있다는 관측과 맞습니다.
조건부 갱신은 성공 경로에서 재고 조회 한 번을 줄입니다. 이번 구현에서는 BEGIN과 COMMIT을 포함해 잠금 읽기 방식은 왕복 5회, 조건부 갱신은 4회입니다. 이 차이가 비용에 영향을 줄 수 있지만, 측정만으로 SQL 왕복·서버 실행·잠금 대기의 기여도를 각각 분리했다고 말할 수는 없습니다.
또한 이 수치는 M1 Pro 위의 Docker, CPU 2개·메모리 2GiB 제한, Python 클라이언트라는 조건에서 얻었습니다. 각 작업자는 응답을 받은 뒤 다음 요청을 보내는 방식입니다. 실제 서비스의 도착률, 네트워크 지연, 다른 쿼리까지 포함한 최대 처리량으로 옮겨 쓸 수 없습니다. 여기서 얻을 수 있는 판단은, 조회 한 번을 줄여도 한 상품에 집중되는 수정 경합은 별도로 살펴봐야 한다는 것입니다.
6. 잠금 종류보다 오래 쥐고 있는 일이 원인
한 상품에 요청이 몰리는 상황을 피하기 어렵다면, 다음으로 줄일 수 있는 것은 각 요청이 잠금을 보유하는 시간입니다. 조건부 UPDATE가 빨리 끝나더라도 잠금은 COMMIT까지 유지됩니다. 따라서 차감 뒤에 DB와 무관한 준비 작업을 오래 수행하면, 다음 요청도 그 준비가 끝나기를 기다려야 합니다.
그 준비를 BEGIN 앞으로 옮기면 여러 요청이 준비 작업을 겹쳐 수행할 수 있습니다. 재고를 확인하고 주문을 저장하는 구간만 잠금으로 보호하는 것입니다.
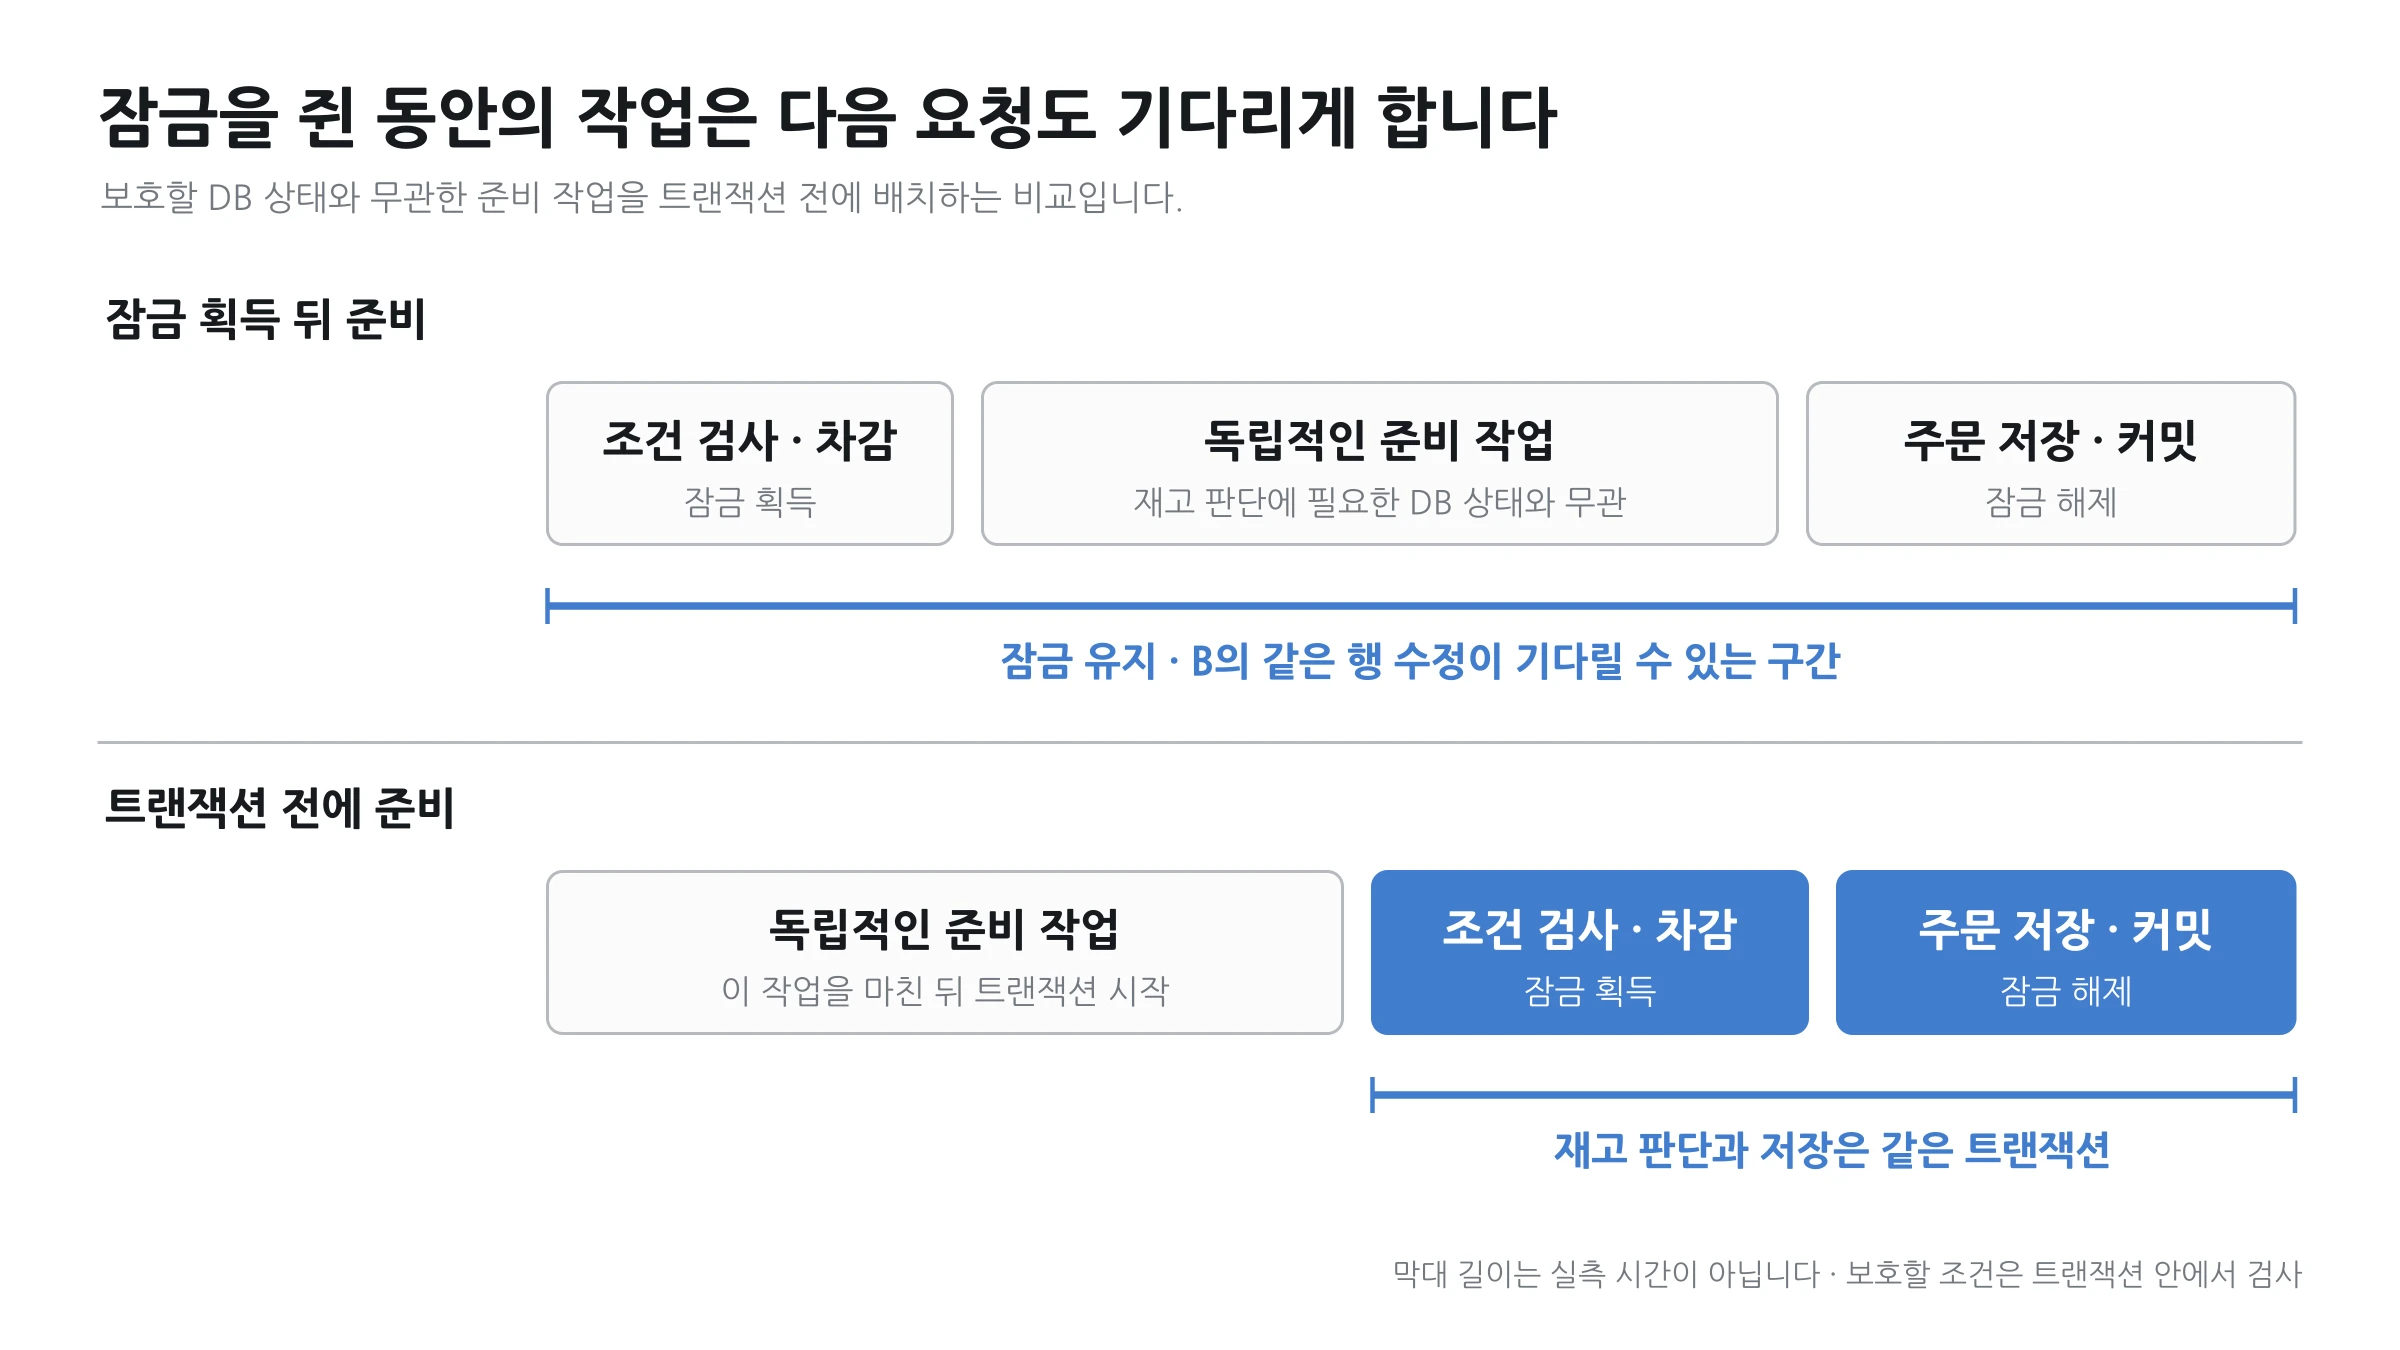
이 차이를 확인하기 위해 DB 상태와 무관한 준비 작업을 20ms의 대기로 대신했습니다. 같은 작업을 UPDATE 이후에 두는 경우와 BEGIN 이전에 두는 경우를 비교한 것입니다. 나머지는 한 상품·16개 작업자·요청 200건·조건부 UPDATE로 같게 두고 각각 3회 실행했습니다. 20ms는 실제 외부 API의 응답 시간이 아니라, 잠금을 오래 보유하는 영향을 드러내기 위해 정한 실험 입력입니다.
| 준비 작업 위치 | 성공 처리량 (건/s) | 요청 지연 p95 (ms) |
|---|---|---|
| UPDATE 이후 | 28.6 | 584.28 |
| BEGIN 이전 | 455.0 | 42.07 |
준비를 밖으로 옮겼다는 이유로 그 시간이 측정에서 빠지면 비교가 공정하지 않습니다. 그래서 이번에는 두 경우 모두 준비 시작부터 COMMIT까지를 측정했습니다. 앞 절의 BEGIN부터 COMMIT까지와 측정 경계가 다른 이유입니다. 표는 3회 처리량과 실행별 p95의 중앙값이며, 모든 실행에서 200건이 성공하고 재고와 주문 수량의 관계도 유지됐습니다.
트랜잭션 안에서는 준비 작업도 상품 잠금을 보유한 시간에 포함됩니다. 다음 요청은 그 작업이 DB를 쓰지 않더라도 기다려야 합니다. 트랜잭션 밖에서는 준비를 겹쳐 진행할 수 있고, 준비를 마친 요청들이 짧은 재고 처리 구간에서 경쟁합니다.
그렇다고 모든 검사를 밖으로 옮기면 되는 것은 아닙니다. 준비 작업이 읽은 DB 상태에 의존한다면, 기다리는 사이 그 상태가 바뀔 수 있습니다. 여기서는 그런 의존성이 없는 작업만 이동했고 재고 조건 검사와 주문 저장은 같은 트랜잭션에 남겼습니다. 외부 결제까지 다룬 실험도 아니므로 결제의 중복 실행이나 보상 문제를 이 결과로 해결했다고 볼 수는 없습니다.
7. 상품이 두 개가 되면 잠금 순서도 중요
지금까지는 하나의 상품을 두 요청이 기다리는 형태였습니다. 주문에 상품이 두 개 들어가면 상황이 달라집니다. A가 상품 1을 잠그고 상품 2를 기다리는 동안, B가 상품 2를 잠그고 상품 1을 기다릴 수 있습니다. 어느 쪽도 필요한 다음 잠금을 얻지 못하는 순환 대기입니다.
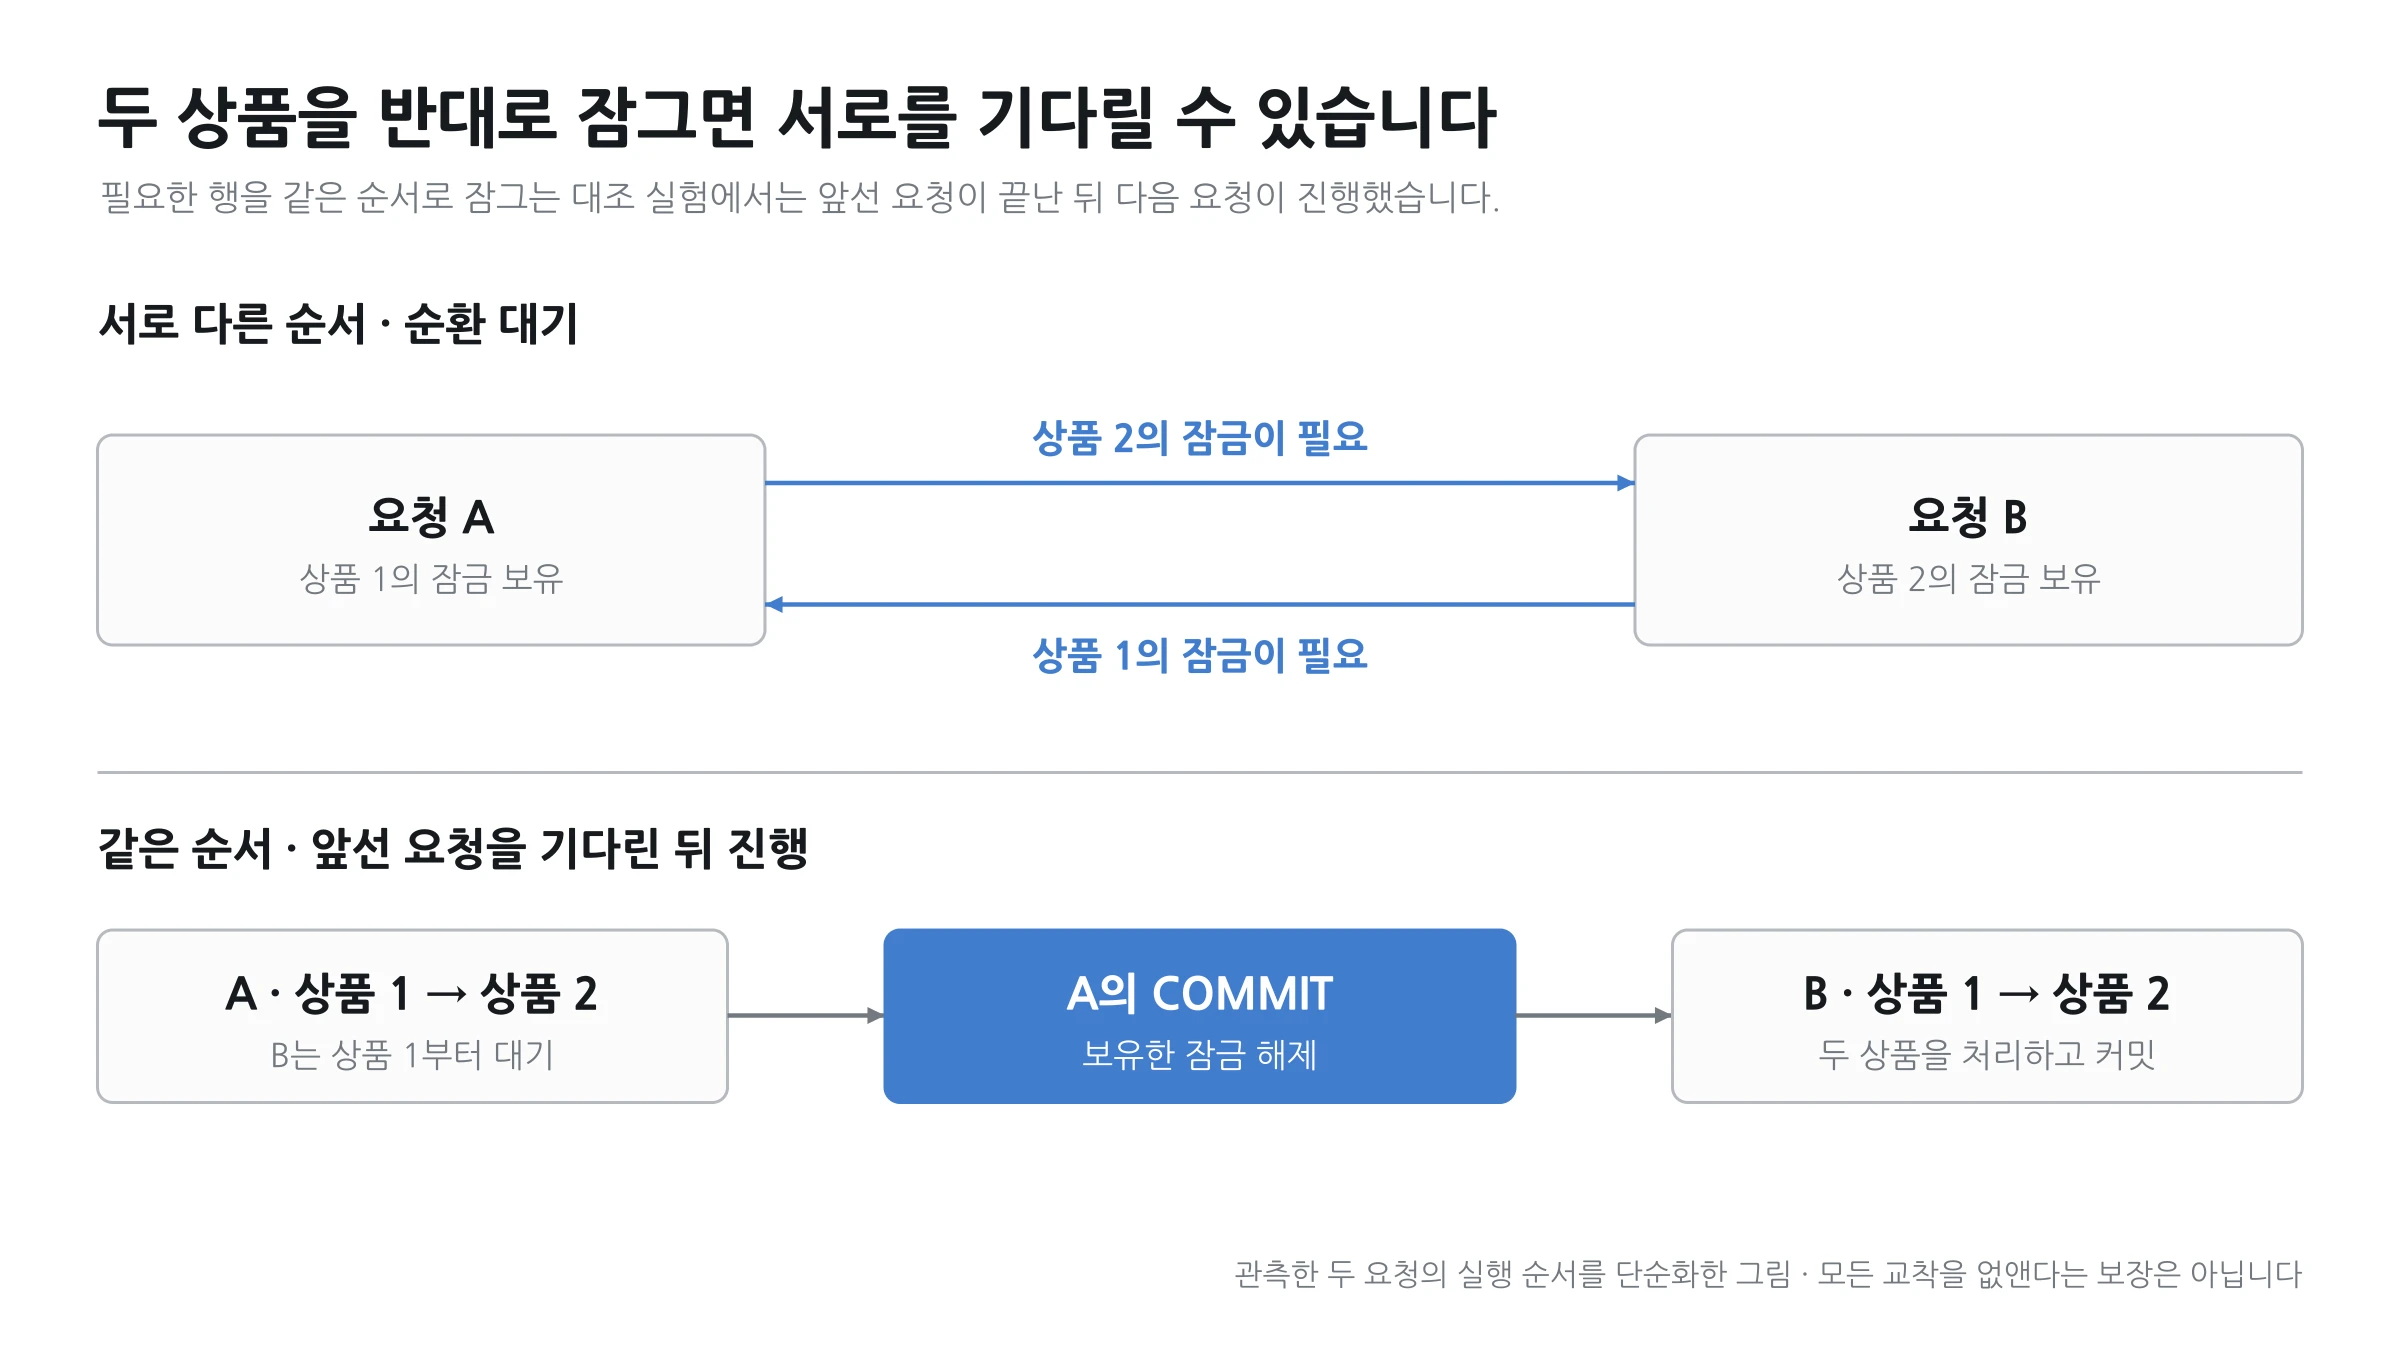
두 연결로 이 순서를 만들자 MySQL은 한 트랜잭션에 오류 1213을 반환하고 다른 쪽을 진행시켰습니다. 어느 요청이 희생자가 될지 정해 놓고 테스트하지 않았습니다. SHOW ENGINE INNODB STATUS에도 해당 교착이 기록됐습니다.
반대로 두 요청이 모두 상품 1 → 상품 2 순서로 잠그도록 바꾸면, B는 첫 상품부터 기다립니다. A는 두 상품을 확보해 끝낼 수 있고 그 뒤 B가 진행합니다. 이 대조에서는 두 트랜잭션이 모두 커밋됐습니다. 특정 순환을 없앤 결과이며, 모든 테이블·인덱스에서 교착이 사라진다는 보장은 아닙니다. 교착을 줄이는 접근 순서
접근 순서를 맞추더라도 교착 오류를 받은 요청이 무엇을 다시 수행해야 하는지는 정해야 합니다. 두 번째 상품을 처리하다 실패했을 때, 첫 번째 상품의 차감과 주문 저장이 남아 있는지에 따라 재시도 범위가 달라지기 때문입니다.
InnoDB는 교착의 희생자로 선택한 트랜잭션을 전체 롤백합니다. 따라서 실패한 SQL 하나만 다시 실행하면, 함께 취소된 첫 번째 상품의 처리가 빠집니다. 재고 확인부터 주문 저장까지 새 트랜잭션에서 다시 수행해야 합니다. 오류별 롤백 범위
실험에서는 각 상품의 재고를 2로 두고, A/B가 자신의 첫 상품을 차감하고 주문 행까지 저장한 뒤 교착하도록 만들었습니다. 희생 요청이 먼저 저장한 주문 행도 사라졌고, 살아남은 요청이 커밋한 뒤에는 두 상품의 재고가 각각 1이었습니다. 실패한 요청의 전체 처리를 새 트랜잭션에서 다시 실행하자, 두 상품 모두 재고 0·주문 수량 합 2가 되어 처음 정한 관계를 지켰습니다.
이번 재시도는 외부 부수 효과 없이 한 번 수행했습니다. 실제 코드에서는 다시 충돌할 가능성도 고려해 재시도 횟수를 제한해야 합니다. 시도 사이의 대기도 새 트랜잭션을 시작하기 전에 두면, 재고를 처리하는 구간에 불필요한 대기를 넣지 않을 수 있습니다.
8. 이 재고 처리에서는 조건부 갱신을 먼저 선택
처음에는 재고가 음수가 되지 않고, 재고 변경과 주문 저장이 함께 커밋되면 충분하다고 생각하기 쉽습니다. 하지만 두 요청이 같은 1을 읽는 순서를 만들자, 최종 수량이 0이어도 주문은 두 건일 수 있었습니다. 확인해야 할 것은 숫자 하나보다 그 숫자를 근거로 주문을 허용하는 과정이었습니다.
이번처럼 한 행의 수량을 조건에 맞춰 차감하는 작업에는 조건부 UPDATE가 잘 맞습니다. 조건을 SQL에 표현할 수 있고, 영향받은 행 수로 주문 저장 여부를 분명하게 나눌 수 있기 때문입니다. 실험에서도 같은 정합성을 유지하면서 조회 한 번을 줄였습니다.
반면 읽은 여러 값을 바탕으로 후속 결정을 내려야 한다면 FOR UPDATE로 필요한 데이터를 보호하는 방식을 검토할 수 있습니다. 어느 쪽을 택하든 잠금 범위와 보유 시간은 남는 문제입니다. 여러 행을 다룰 때는 접근 순서와 전체 트랜잭션 재시도까지 함께 설계해야 합니다.
| 작업의 조건 | 먼저 검토할 방법 | 함께 확인할 것 |
|---|---|---|
| 한 행의 재고를 조건에 맞춰 차감 | 조건부 UPDATE | 갱신 행 수, 주문과 같은 트랜잭션 |
| 읽은 값을 보호하며 후속 판단 | FOR UPDATE | 잠금 범위, 보유 시간 |
| 여러 상품을 한 주문으로 처리 | 일관된 접근 순서와 실패 처리 | 전체 롤백, 제한된 재시도 |
이 글의 결론을 ‘조건부 갱신이 언제나 빠르다’로 가져가지는 않으려 합니다. 더 오래 남길 기준은 세 가지입니다. 어떤 값을 보고 판단하는지, 그 판단을 어디까지 보호하는지, 실패하면 무엇을 다시 수행하는지입니다. 이 기준을 먼저 정하면, 잠금 문법과 트랜잭션 경계도 해당 업무에 맞춰 선택할 수 있습니다.