[Knot] 녹음 모델 전사 품질 개선 과정
이 글의 목차9개
문제점
저희 팀에서는 클로바 노트가 있는데 왜 이 서비스를 써야 하죠?라는 질문을 자주 받았습니다.
다른 부가적인 기능을 제외하더라도 전사 품질은 적어도 다른 전사 서비스만큼 보장되어야 한다고 생각했습니다.
그래서 전사 품질 및 화자 분리를 개선하려고 노력했습니다.
이번 글에서는 그 과정에서 어떤 오류를 발견했고, 무엇을 바꿨으며, 어떤 기준으로 최종 구성을 선택했는지 기록했습니다.
크게 2가지 키워드로 나눌 수 있습니다.
- 정답 제작과 품질 평가
- 시간축 복원과 화자 연결 개선
1. 정답 만들기
평가하기 전에는 정답이 필요했습니다.
’개선되었다’고 말하려면 정답을 기준으로 해야 하니까요.
전사 결과를 읽다 보면 이전보다 자연스러워졌다는 느낌은 들었습니다.
하지만 문장이 자연스러운 것과 실제로 한 말을 정확히 적는 것은 달랐습니다.
문제가 있었다. 문제가 없었다.
위 예시처럼 비슷한 발음 하나만 바뀌어도 각각 자연스럽지만 반대의 뜻이 되어버리므로, 숫자나 부정 표현 하나가 바뀌면 회의에서 결정한 내용도 다르게 읽힐 수 있었습니다.
자연스러운 글을 AI가 채점하는 것은 정답인지 알아낼 수 없었습니다.
문제가 있었다. 문제가 없었다.
라는 문장에 모두 AI는 자연스러운 문장이라는 평가를 합니다.
그러므로, 결국 직접 음성을 들어보며 테스트해야 했습니다.
하지만 많은 음성 파일을 모두 들으며 전사하기에는 시간이 너무 많이 들기에, HTML 비교 화면을 만들어 클로바노트, Knot 모델에서 서로 어긋난 부분만 직접 듣고 어떤 것이 정답인지 채점하는 작업을 했습니다.
이 작업으로 약 30시간 정도의 녹음 파일에 대한 정답을 만들어냈습니다.
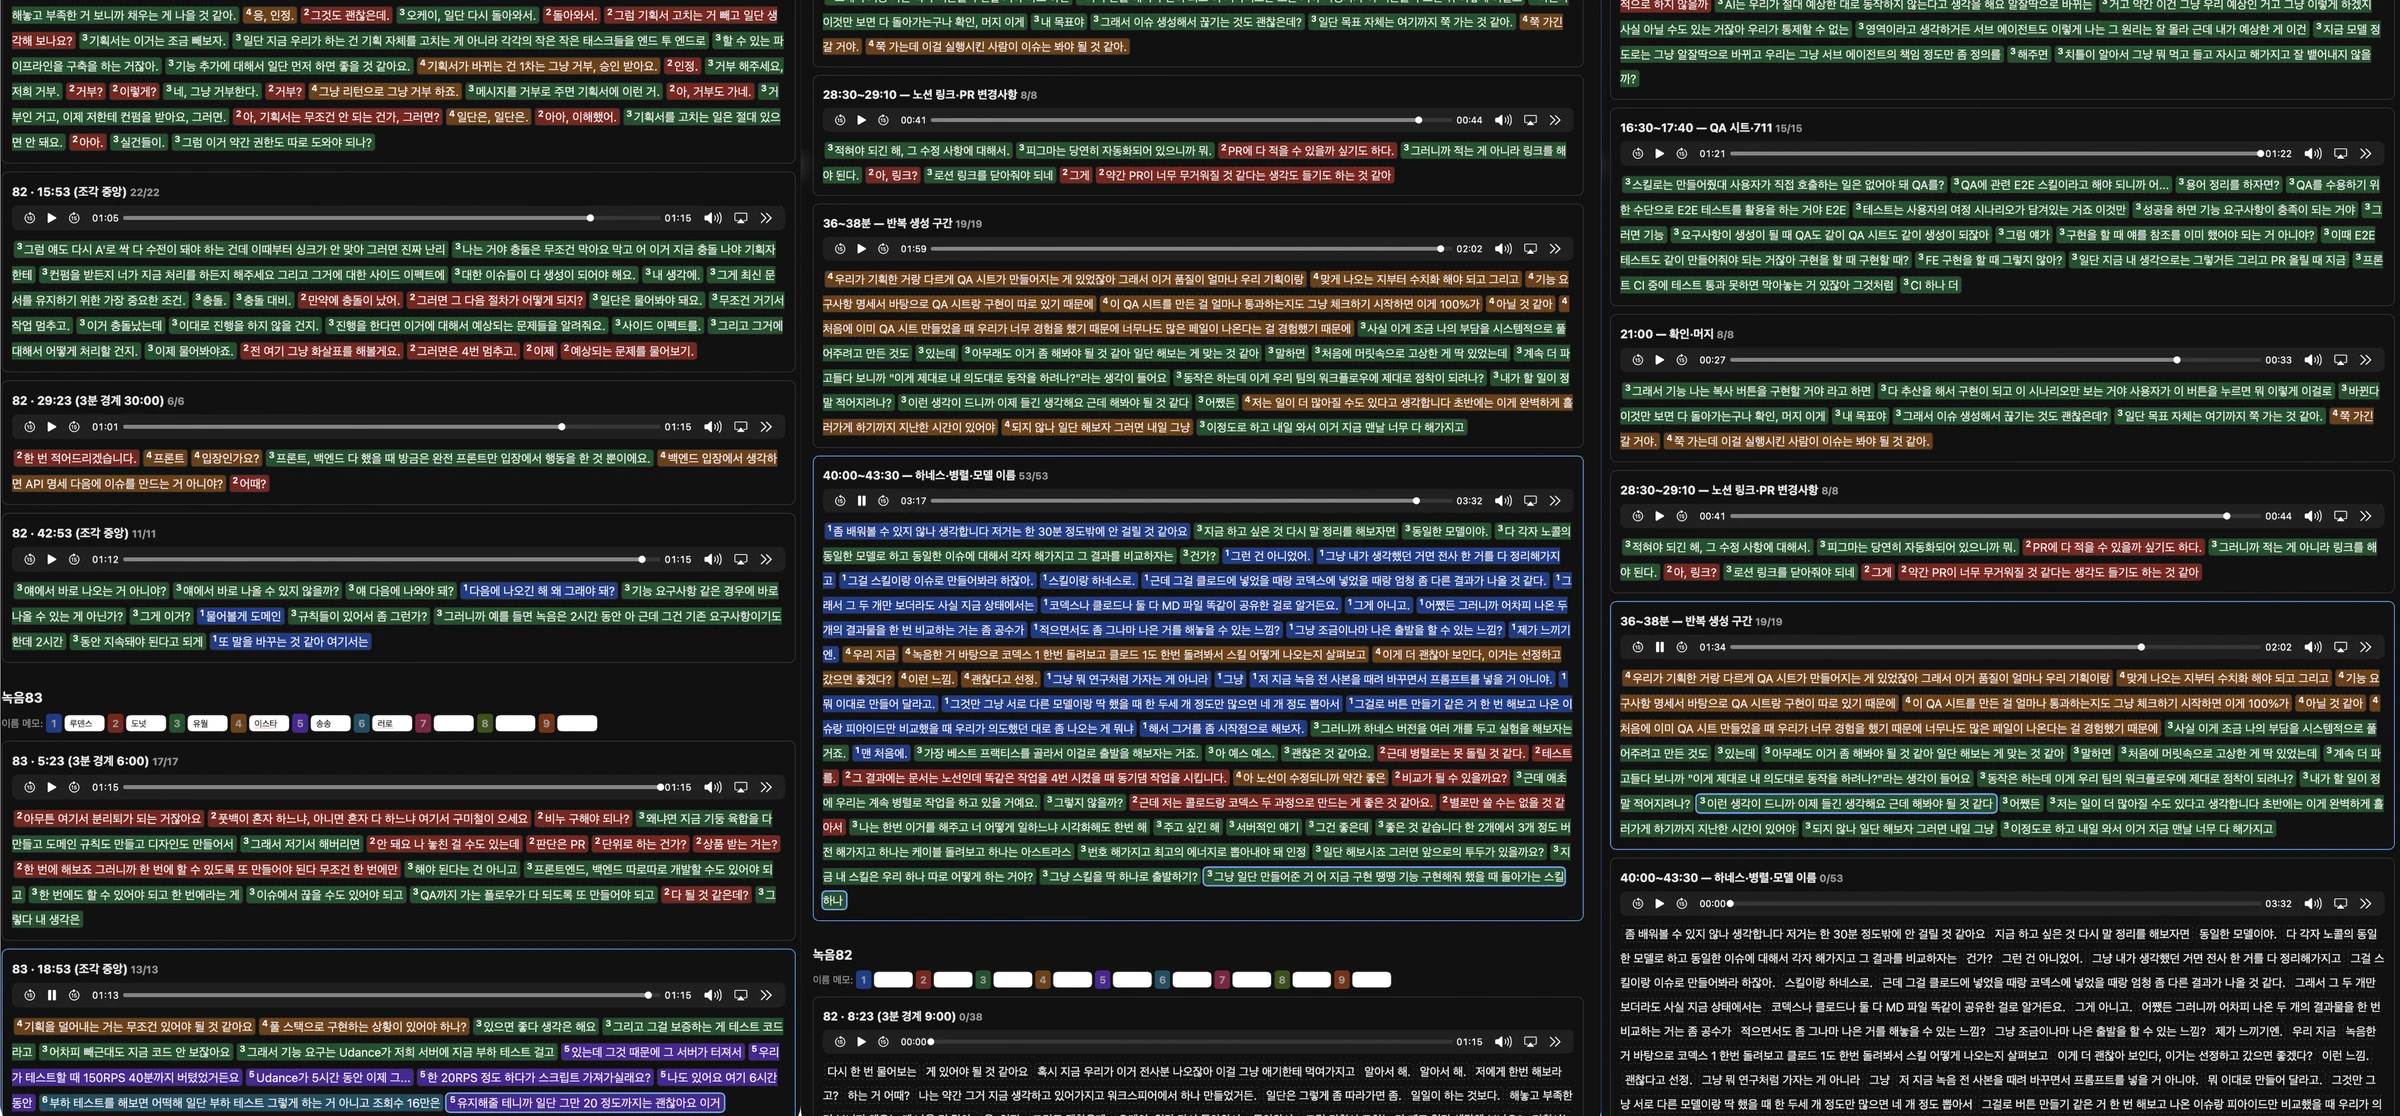
물론, 이 방식에는 한계도 있었습니다. 클로바 노트와 knot 모델이 정확히 일치한 오답을 낸 경우에 해당 오답에 대한 점검을 할 수 없었지만, 그 가능성은 낮다고 판단했고, 많은 정답을 통해서 성능을 개선할 수 있다고 생각했습니다.
2. 품질 평가
정답을 만든 뒤에는 모델과 실행 설정을 바꿔가며 결과를 비교했습니다.
맥미니 서버 자원을 조금 더 사용하더라도 전사 품질을 높일 수 있다면 바꿀 생각이었습니다.
텍스트는 정답의 글자를 다른 글자로 바꾸거나, 빠뜨리거나, 더 넣은 수를 세어 글자 오류율로 비교했습니다.
- 공백과 문장부호는 제외
- 화자 구분은 별도 평가
- 사람이 표시한 화자와 모델의 화자를 대응시켜, 발언이 맞는 사람에게 배정된 시간 비교
다른 모델은 어땠을까?
먼저 현재 사용하는 Whisper large-v3 대신 다른 모델을 사용할 수 있는지 확인했습니다. large-v3-turbo로 전체 파일을 전사하고, large-v3도 같은 방식과 문맥 설정으로 실행했습니다.
다섯 녹음의 평가 구간을 합산했을 때 글자 오류율은 large-v3가 8.9%, turbo가 11.9%였습니다. 이 자료에서는 turbo로 바꿀 품질상의 이점을 얻지 못했습니다.
현재 사용하던 Q5_0 양자화 모델 대신 f16 모델도 실행했습니다.
모델의 수치를 더 높은 정밀도로 표현하면 결과도 좋아지는지 확인하려는 실험이었습니다.
별도 평가 구간에서는 f16이 더 좋은 결과를 내지 못했습니다. Qwen3-ASR도 같은 평가 구간에 적용했지만 기존 Whisper 구성보다 오류율이 높았습니다.
비교한 자료와 설정 안에서는 모델을 교체하거나 정밀도를 높이는 것만으로 품질이 좋아지지는 않았습니다.
같은 모델도 설정에 따라 결과가 다르다
앞서 전사한 내용을 다음 전사의 문맥으로 참고하게 할지, 인식이 불확실할 때 다른 설정으로 다시 시도하게 할지도 비교했습니다. 모델 파일이 같아도 이 조건에 따라 누락과 반복이 달라졌습니다.
전체 파일을 전사할 때는 이전 문맥을 참고하지 않는 설정에서 오류가 줄었습니다.
하지만 나눠 전사할 때 모든 구간에 같은 설정을 적용하니 오히려 오류가 늘었습니다.
인식이 불확실할 때 설정을 바꿔 재시도하는 temperature fallback을 끈 경우에도 결과가 나빠졌습니다.
한 녹음에서 좋아진 설정이 다른 녹음이나 처리 방식에서도 나은지 확인해야 했습니다. 모델과 설정을 비교할 때는 가능한 한 같은 입력과 정답을 사용했고, 모델 외에 처리 조건이 달라진 비교는 그 차이를 함께 기록했습니다.
3. 화자를 연결하기
음성 인식이 정확하게 되는지 확인한 뒤에는 누가 말했는지 연결할 차례였습니다.
이 부분에도 문제가 많았습니다. 말은 맞게 적혔는데 다른 사람의 발언으로 표시되거나, 같은 사람이 구간마다 다른 화자가 되기도 했습니다.
단어와 화자의 시간 기준이 다른 문제
단어에 화자를 붙일 때는 그 말을 한 시각과 화자가 말한 시각을 비교했습니다.
그런데 두 시각의 기준이 달랐습니다.
당시 whisper.cpp에서 무음을 제거한 뒤 얻은 단어 시각을 원음에서 분석한 화자 시각과 그대로 비교하고 있었습니다.
앞의 침묵 3초를 제거했다면 원음의 10초에 있던 말이 처리한 음성에서는 7초에 놓일 수 있습니다.
이 7초를 원음의 화자 구간과 비교하면 다른 사람의 발언으로 붙을 수 있었습니다.
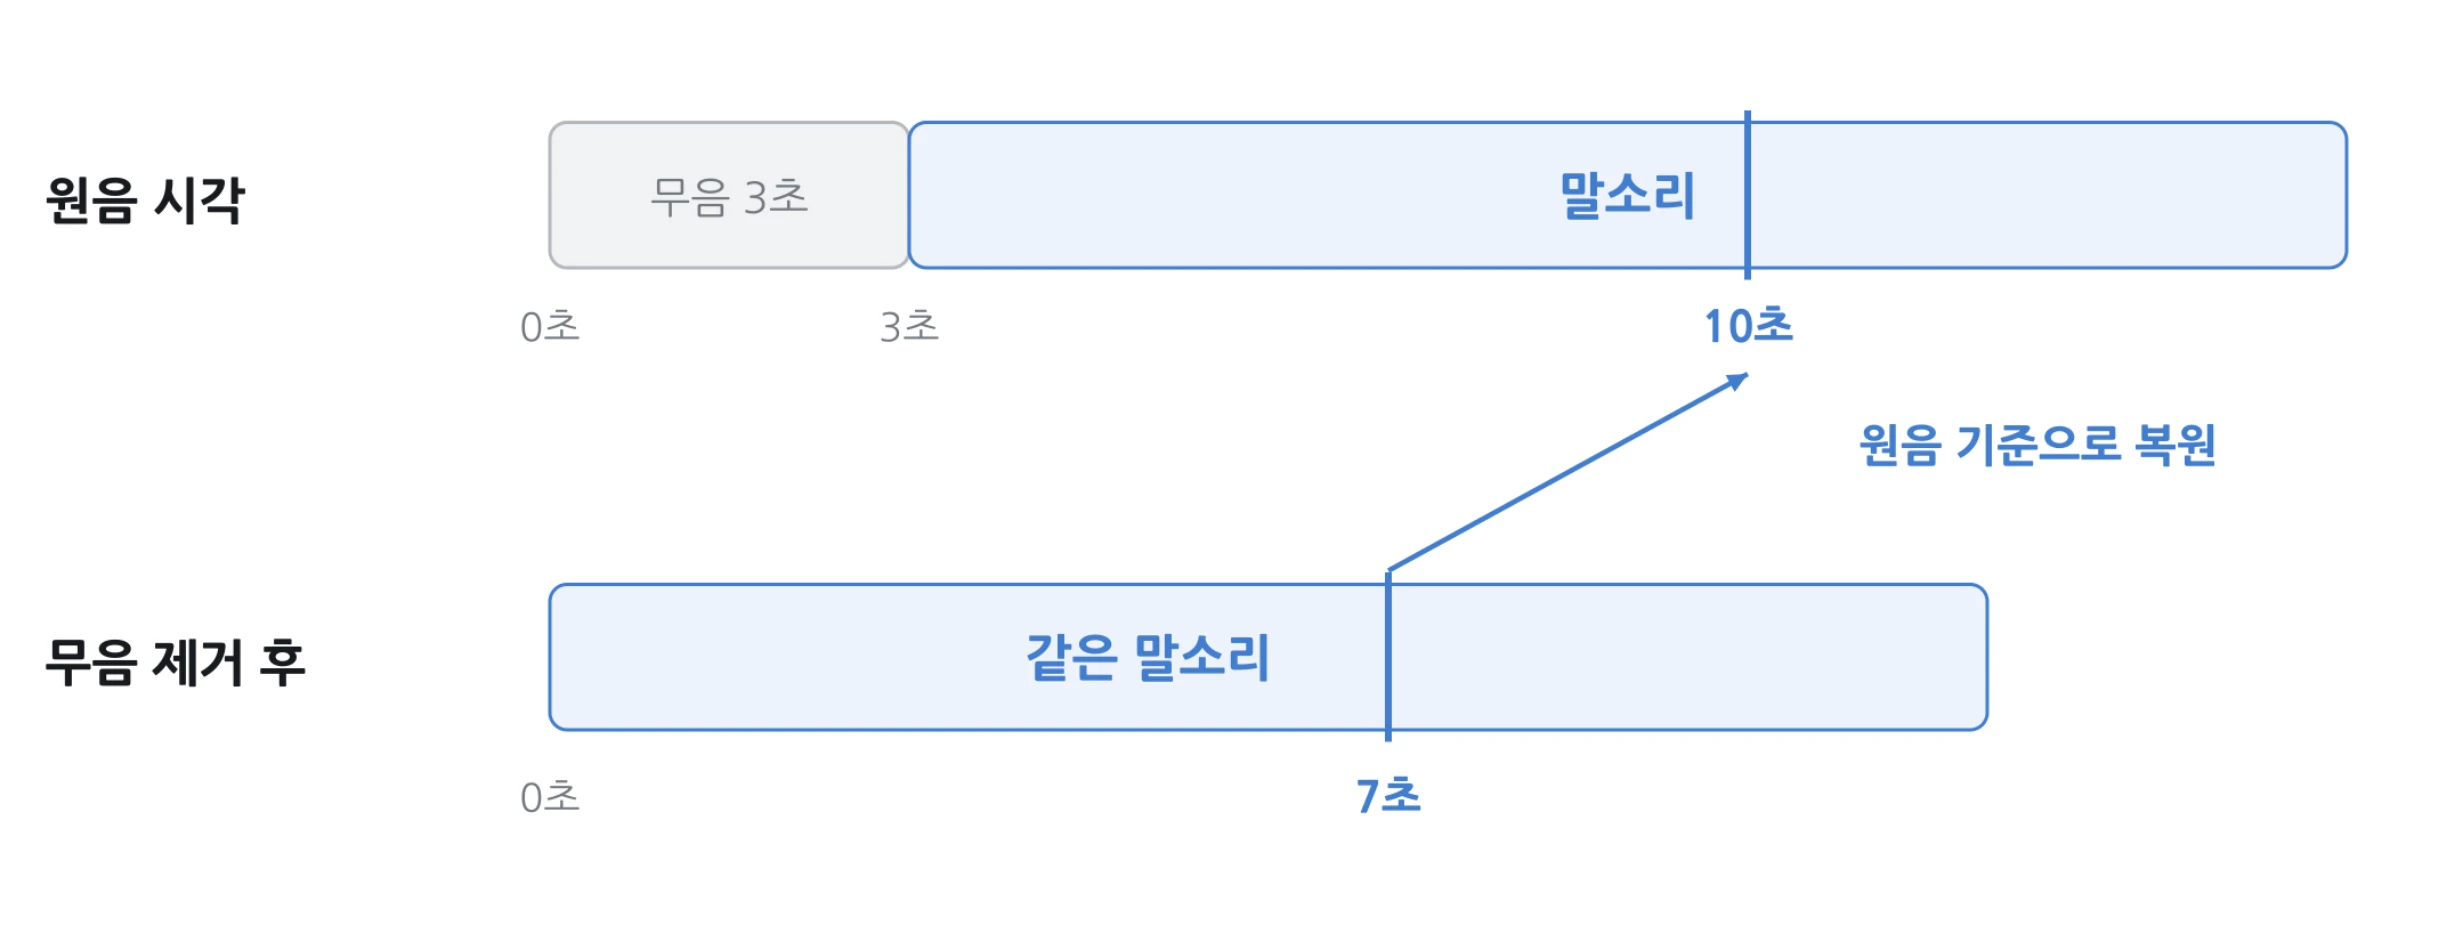
그래서 단어 시각을 원음 기준으로 복원하도록 whisper.cpp를 보완했습니다.
나눠 처리한 음성은 구간의 시작 위치도 더해 회의 전체 시각으로 맞춘 뒤 화자를 연결했습니다.
구간마다 달라지는 화자 번호 문제
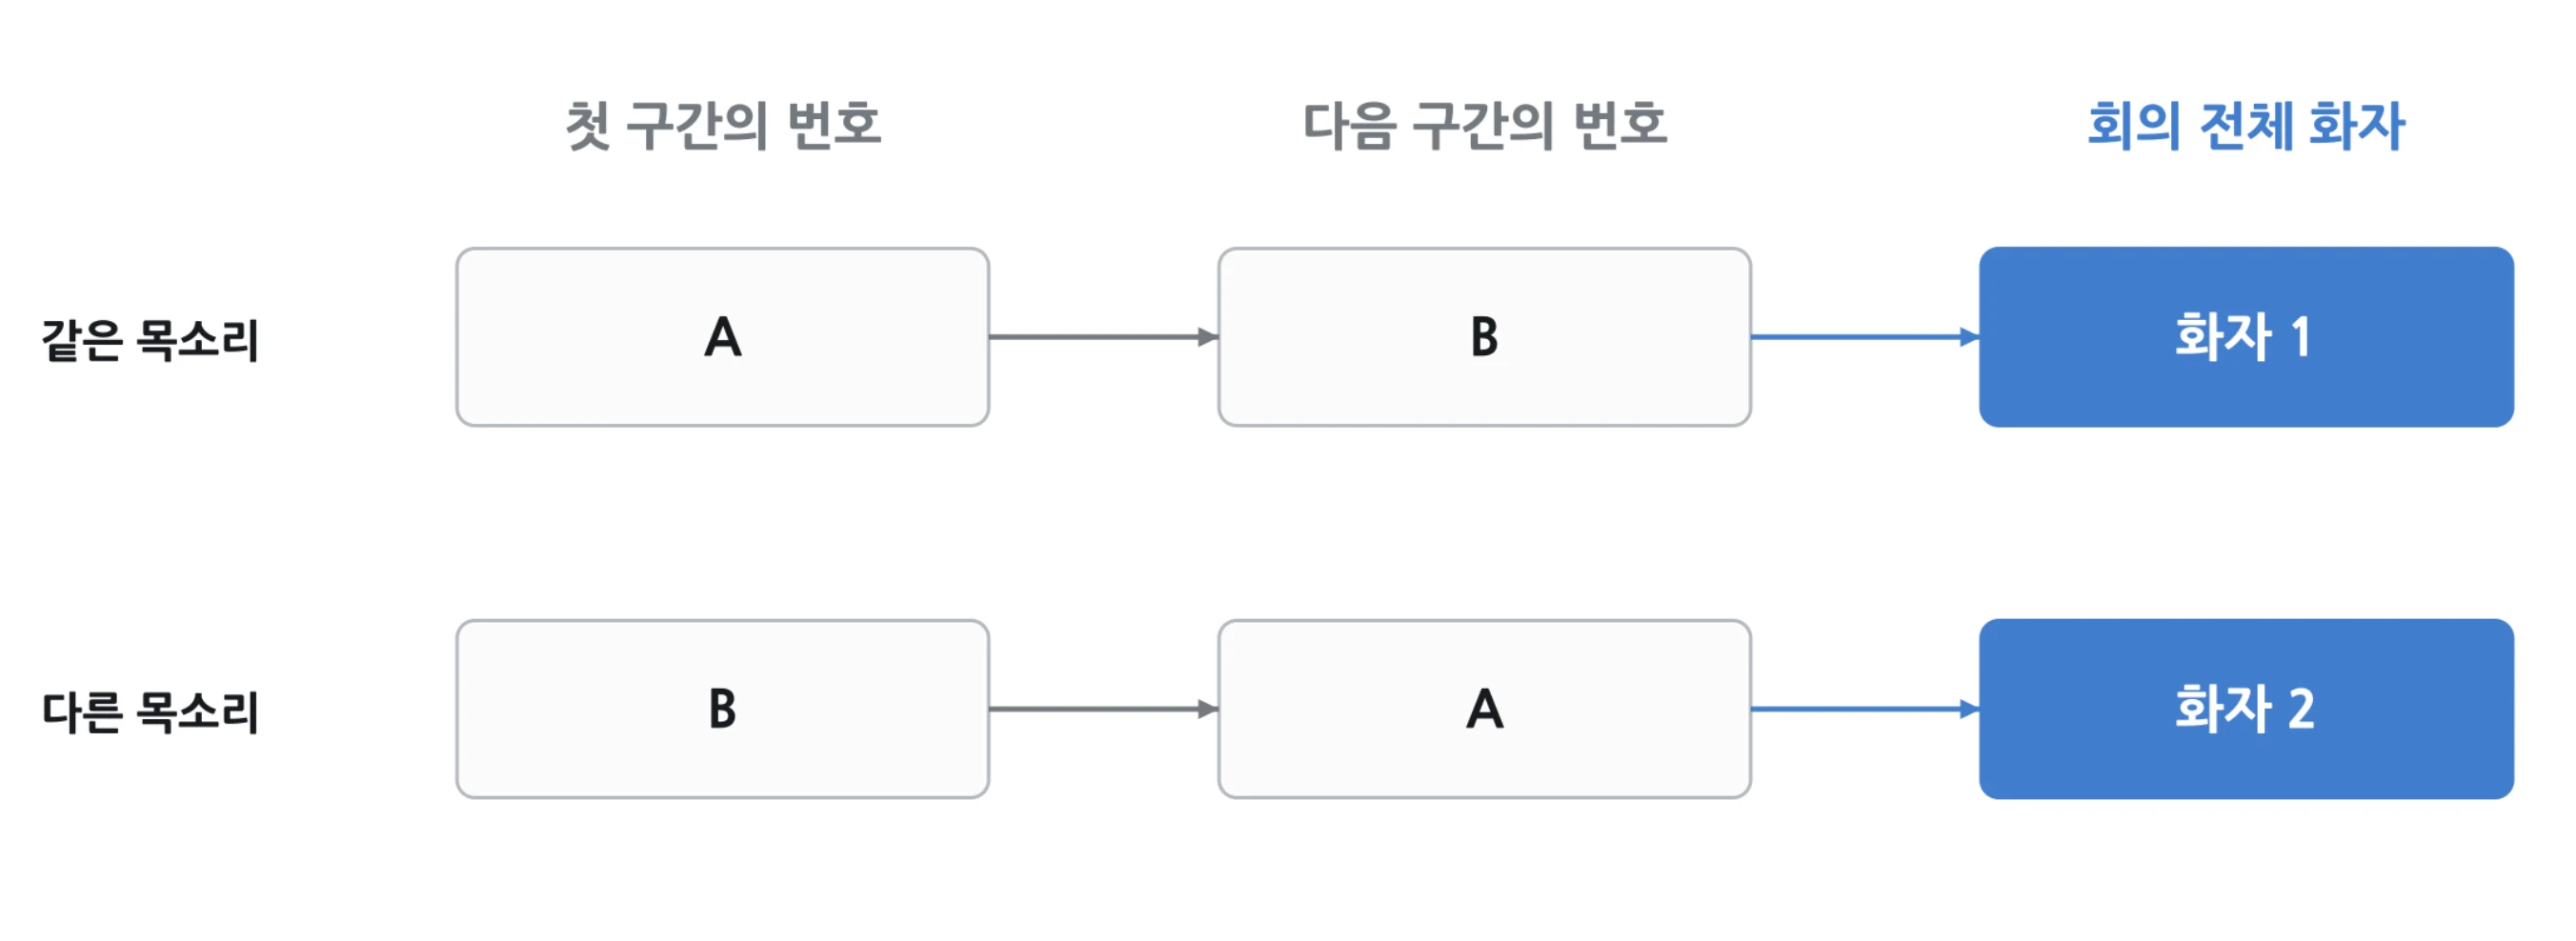
한 구간에서 A였던 사람이 다음 구간에서도 A인 것은 아니었습니다.
구간별 번호를 그대로 연결하면 같은 사람이 여러 화자로 나뉘거나 다른 사람의 발언이 섞였습니다.
그래서 ERes2Net으로 추출한 목소리 특징을 구간마다 모으고, 회의 전체에서 비슷한 발언끼리 다시 묶었습니다.
번호가 같다는 이유로 연결하지 않고 실제 목소리 특징을 비교하려고 했습니다.
4. 상용 서비스와 비교하기
결과적으로, Knot의 정확도는 다른 전사 서비스와 비슷한 수준까지 향상되었습니다.
실험은 개발, 의료, 보건 토론 음성 약 10시간을 평가했으며, 같은 음원과 정답으로 비교했습니다.
음원마다 정답 글자 수가 다르므로, 정답 글자 수로 가중 합산한 문자 정확도를 사용했습니다.
| 서비스 | 문자 정확도 |
|---|---|
| Knot | 91.81% |
| 클로바노트 | 93.29% |
| 다글로 | 92.93% |
| Aiko | 89.60% |
| 애플 음성 녹음 | 69.82% |