[Knot] Knot의 전사 모델을 고르기까지
이 글의 목차14개
Knot 프로젝트의 필수 요소는 녹음, 문서, 탐색입니다.
이 글에서는 로컬 모델을 선택한 이유와 전사에 필요한 모델들의 역할, 직접 결과를 확인하며 개선을 시도한 과정을 기록했습니다.
전사: 음성을 텍스트로 바꾸는 과정 / STT(Speech-to-Text)
목차는 다음과 같습니다.
- 외부 API를 사용하지 않은 이유
- 전사에는 어떤 모델들이 필요했을까
- 초기 전사 결과와 개선 시도
- 현재 Knot의 전사 구성
1. 외부 API를 사용하지 않은 이유
선택지는 외부 API와 로컬 모델이었습니다.
API는 전사 품질이 좋고, 직접 개선해야 할 부분이 적어 구현에 드는 공수가 작았습니다.
대신 녹음한 음성의 길이만큼 사용료를 지불해야 했습니다.
로컬 모델은 저희가 관리하는 장비에서 직접 실행하는 방식입니다.
당시 비교한 후보에서는 API보다 전사 품질이 떨어졌지만, 별도의 전사 API 요금 없이 사용할 수 있었습니다.
품질을 개선하고 모델을 운영하는 일은 직접 맡아야 했습니다.
비교한 API의 가격은 다음과 같았습니다.
| 방식 | 당시 과금 기준 | 녹음 1시간의 전사 비용 |
|---|---|---|
| CLOVA Speech | 15초당 5원 | 약 1,200원 |
| OpenAI API | 분당 $0.0045 | 약 370원 |
한 시간에 몇백 원에서 천 원 정도라면 괜찮아 보일 수도 있습니다.
하지만 실제 사용량을 넣어보니, API 비용은 저희가 생각했던 것보다 비쌌습니다.
저희 팀만 해도 하루에 몇 시간씩 회의를 하고 녹음했습니다.
하루 3시간씩, 한 달에 20일을 녹음한다고 가정하면 팀 하나에서만 월 60시간의 음성을 처리해야 했습니다.
| 사용량 예시 | OpenAI API | CLOVA Speech |
|---|---|---|
| 한 팀이 하루 3시간, 월 20일 녹음 | 월 약 2만 2,200원 | 월 약 7만 2,000원 |
| 같은 양을 녹음하는 팀이 10개 | 월 약 22만 2,000원 | 월 약 72만 원 |
10팀이 평일 하루 3시간을 녹음하면 CLOVA 기준으로 월 약 72만 원이 예상됐습니다.
수익 없이 운영하는 프로젝트에서 이 비용을 계속 부담하기는 어렵다고 판단했습니다.
그래서 전사 API 요금이 없는 로컬 모델을 선택하고, 부족한 품질은 직접 개선해보기로 했습니다.
장비와 전력, 운영에 드는 부담은 남았지만, 사용량에 따라 늘어나는 API 비용을 줄일 수 있었습니다.
예전부터 맥미니가 눈에 아른아른 거렸는데, 이번 기회를 빌미로 삼아 중고 맥미니를 구매했습니다.
2. 전사에는 어떤 모델들이 필요했을까
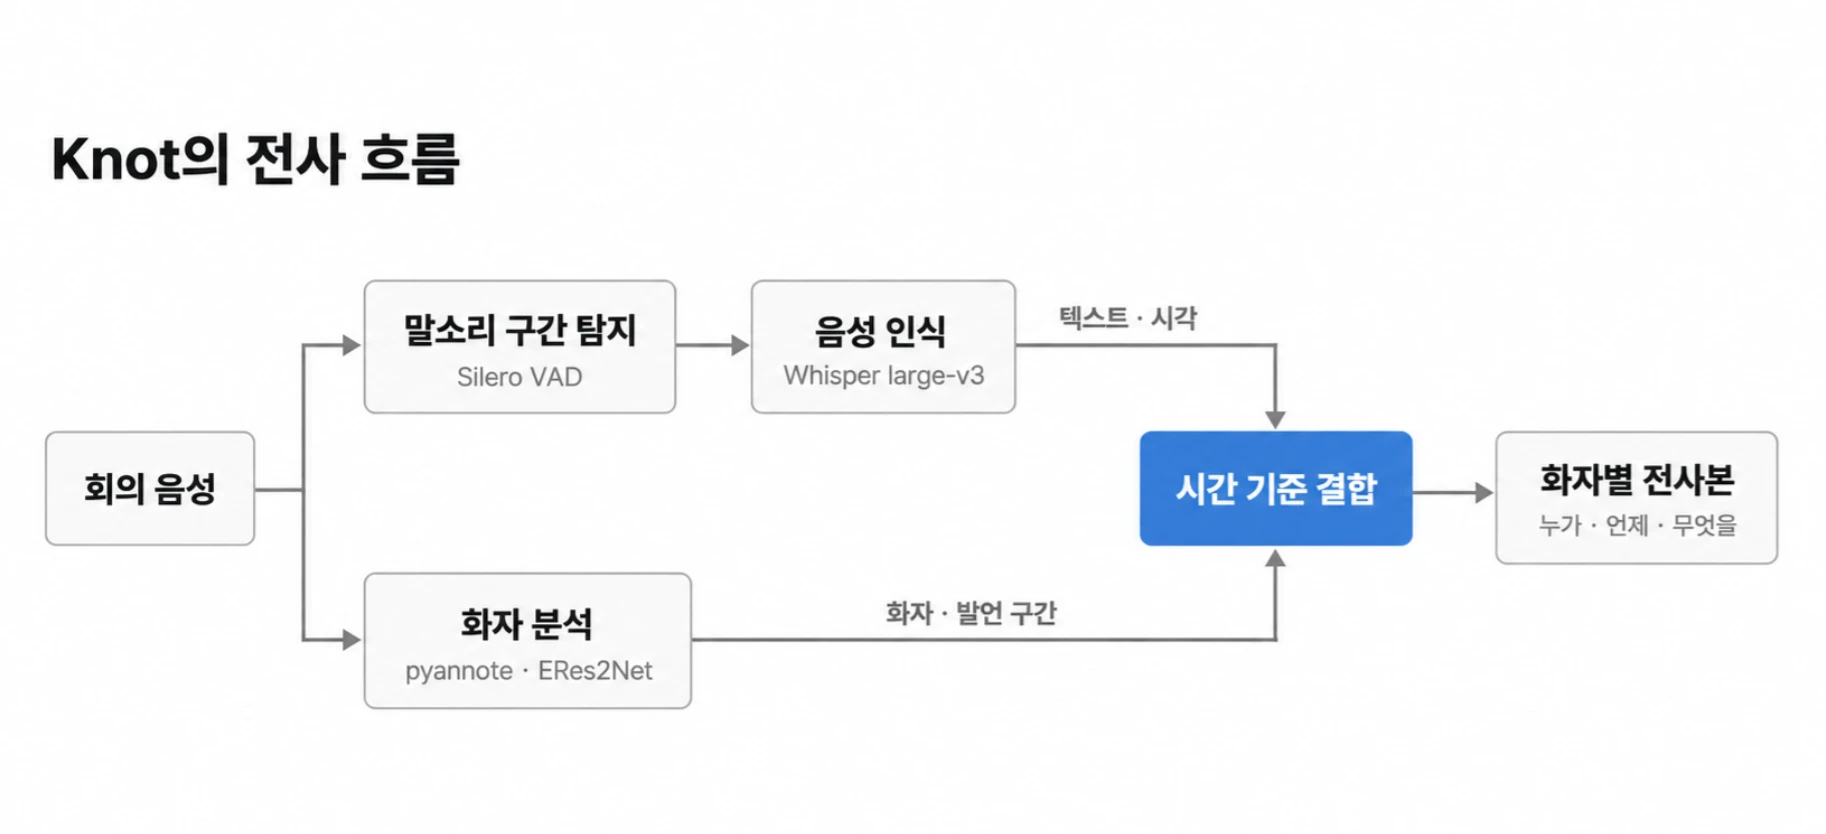
Knot에는 회의 내용을 글로 옮기는 것뿐 아니라, 누가 언제 말했는지도 기록하는 기능이 필요했습니다.
이를 위해 다음 역할을 하는 각각의 모델을 연결했습니다.
- 말소리가 있는 구간을 찾는 모델
- 무슨 말을 했는지 받아쓰는 모델
- 누가 말했는지 구분하는 모델
총 4개의 모델로 같은 음성을 두 갈래로 분석합니다.
한쪽에서는 텍스트와 시각을 얻고, 다른 쪽에서는 화자와 발언 구간을 얻습니다.
두 결과의 시간을 맞춰 연결하면 화자별 전사본이 만들어집니다.
말소리가 있는 구간 찾기
음성에서 말소리가 있는 구간을 찾는 처리를 VAD라고 합니다.
현재 Knot에서는 Silero VAD를 사용합니다.
왜 VAD가 필요할까요?
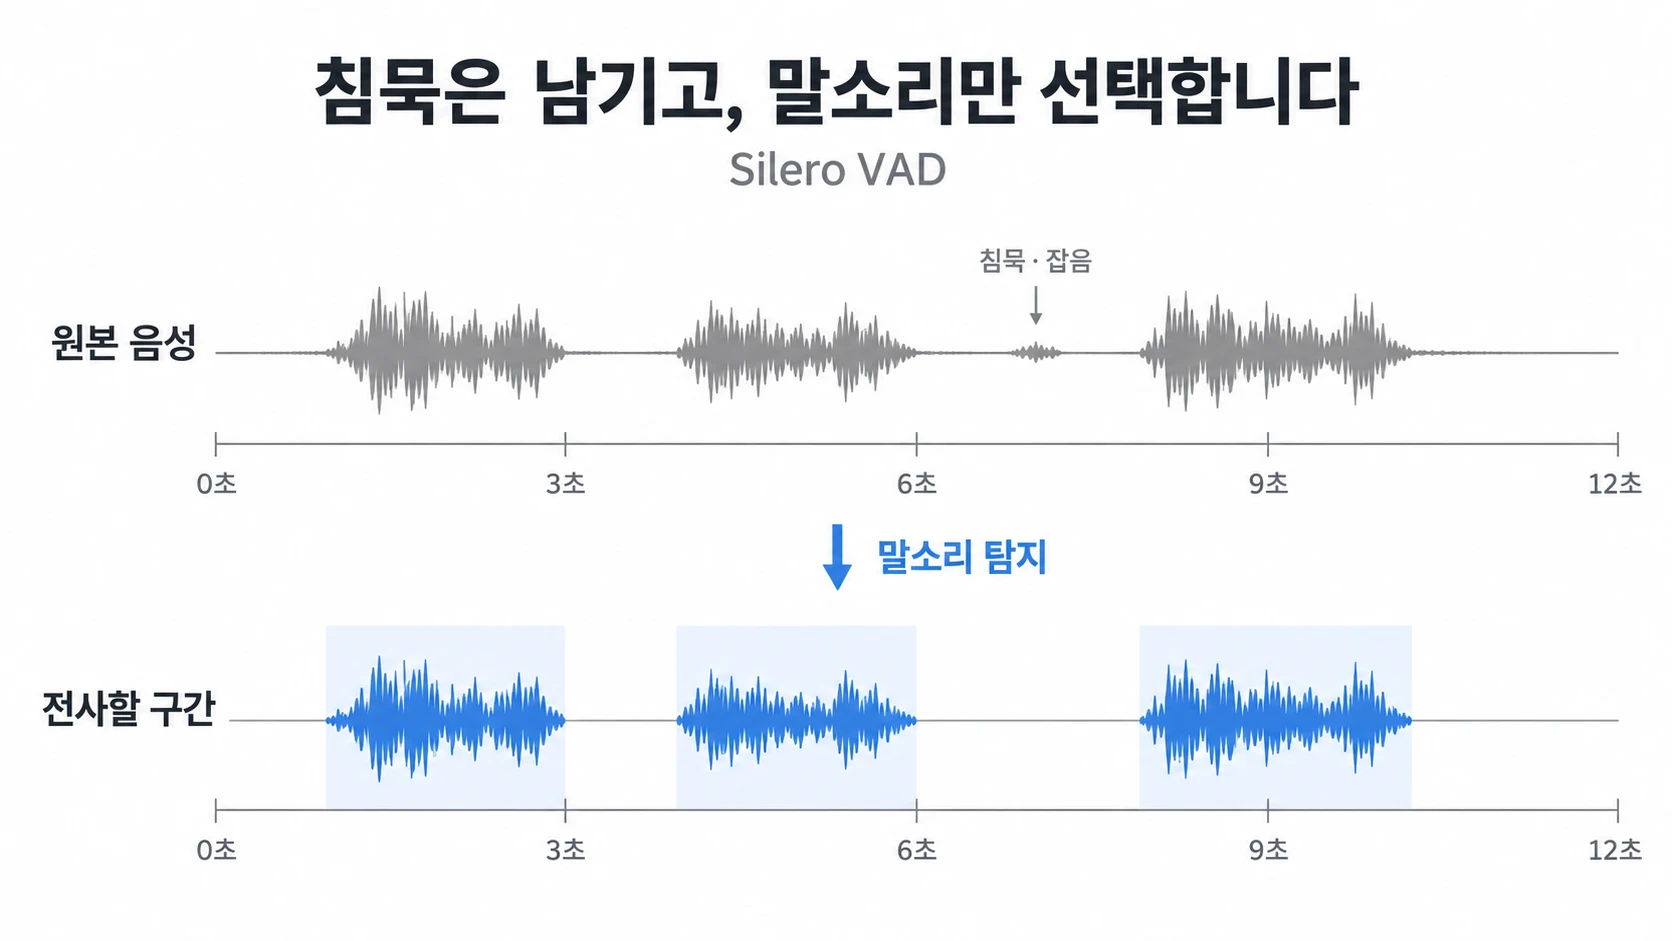
회의 녹음에는 사람이 말하는 시간뿐 아니라 침묵과 잡음도 들어갑니다. Whisper 같은 음성 인식 모델은 이런 구간에서 실제로 하지 않은 말을 출력하기도 합니다.
작은 잡음이라도 음성 인식 모델은 이 소리가 어떤 말과 가장 가까운가?를 판단할 뿐이기 때문입니다.
이를 환각이라고 하며, 아무 말도 하지 않은 구간에 문장이 생길 수 있다는 뜻입니다.
그러므로 받아 적을 말소리가 있는 구간을 먼저 찾는 작업이 필요합니다. Silero VAD는 사람이 말하는 것으로 판단한 구간의 시작과 끝 시각을 반환합니다.
이 정보를 바탕으로 해당 음성을 추출해 음성 인식 모델에 전달합니다.
발언을 글로 옮기기
VAD가 찾아준 것은 말소리가 있는 구간입니다.
아직 그 사람이 무슨 말을 했는지는 모릅니다.
이 소리를 글로 바꾸는 역할을 Whisper가 맡습니다.
Whisper는 음성에서 추출한 특징을 읽고, 그에 대응하는 텍스트 조각을 순서대로 생성합니다.
소리를 글로 옮기는 흐름을 단순화하면 다음과 같습니다.
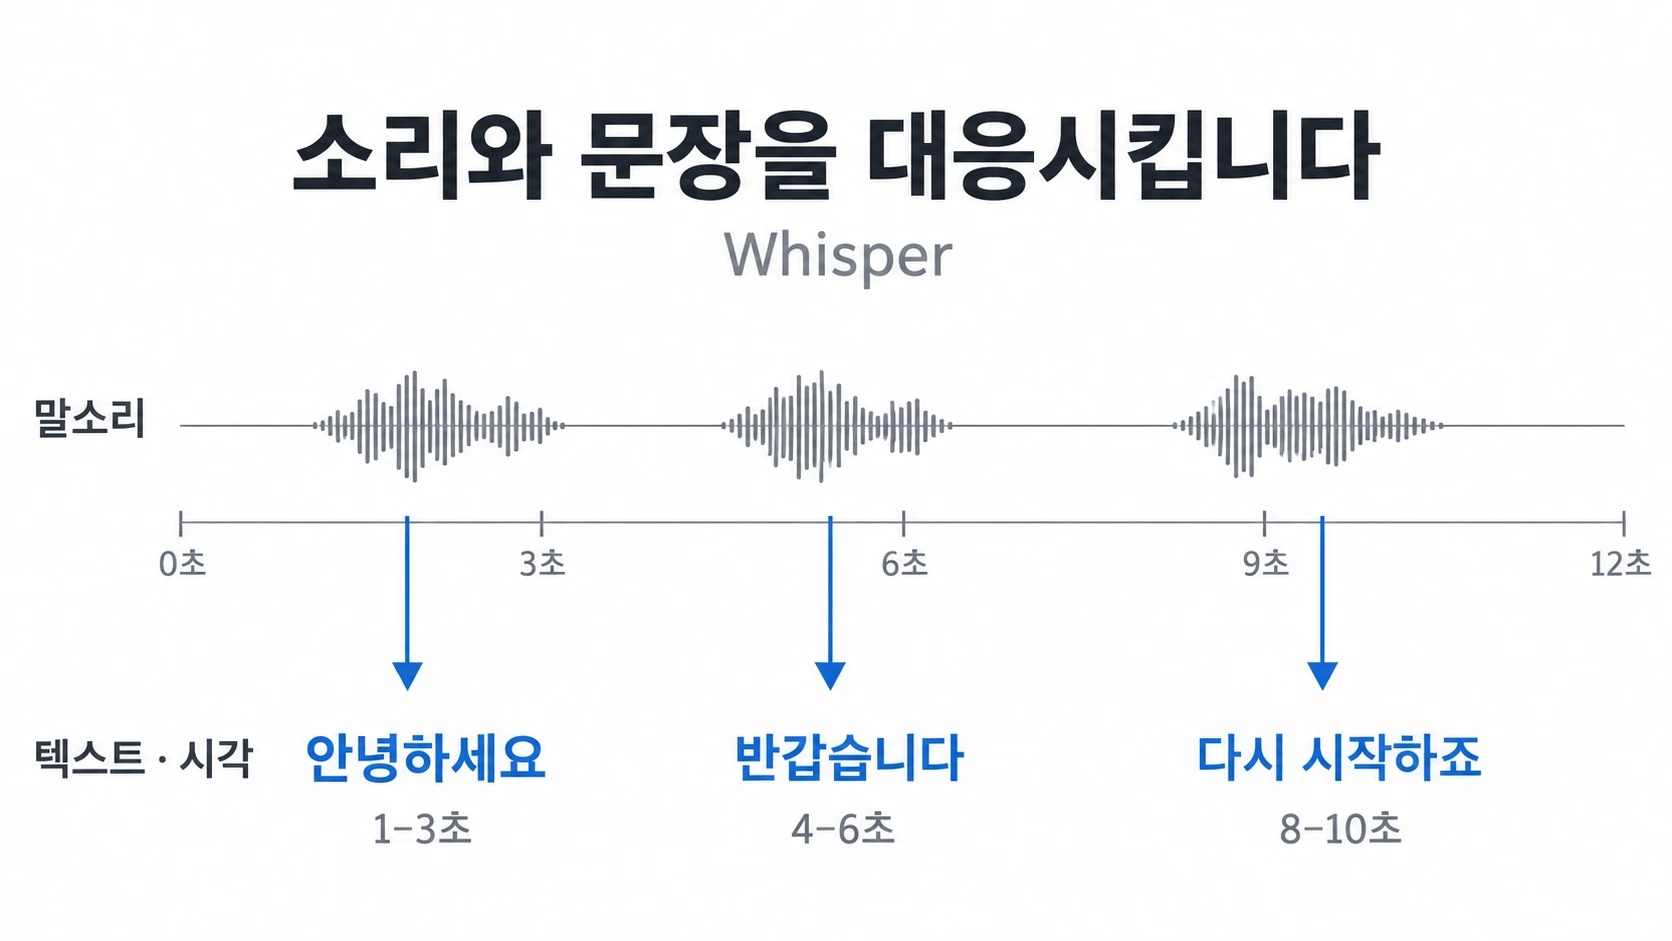
여기까지의 과정으로 언제 어떤 말을 했는지 알 수 있습니다.
하지만, 화자 분리를 위해서는 누가 말했는지 별도로 구분해야 합니다.
화자별로 말한 구간 찾기
VAD가 말소리를 찾았다면, 화자 구분에도 그대로 쓰면 되지 않을까요?
VAD가 알려주는 것은 그 시간에 말소리가 있는지입니다.
두 사람이 번갈아 말하더라도, 말소리가 있다는 정보만으로는 사람이 바뀌었는지 알 수 없습니다.
그래서 같은 음성을 pyannote segmentation에도 전달합니다.
이 모델은 짧게 나눈 음성 안에서 각 화자가 언제 말하는지 추정합니다.
사람이 번갈아 말하거나 여러 사람이 동시에 말하는 경우도 분석합니다.
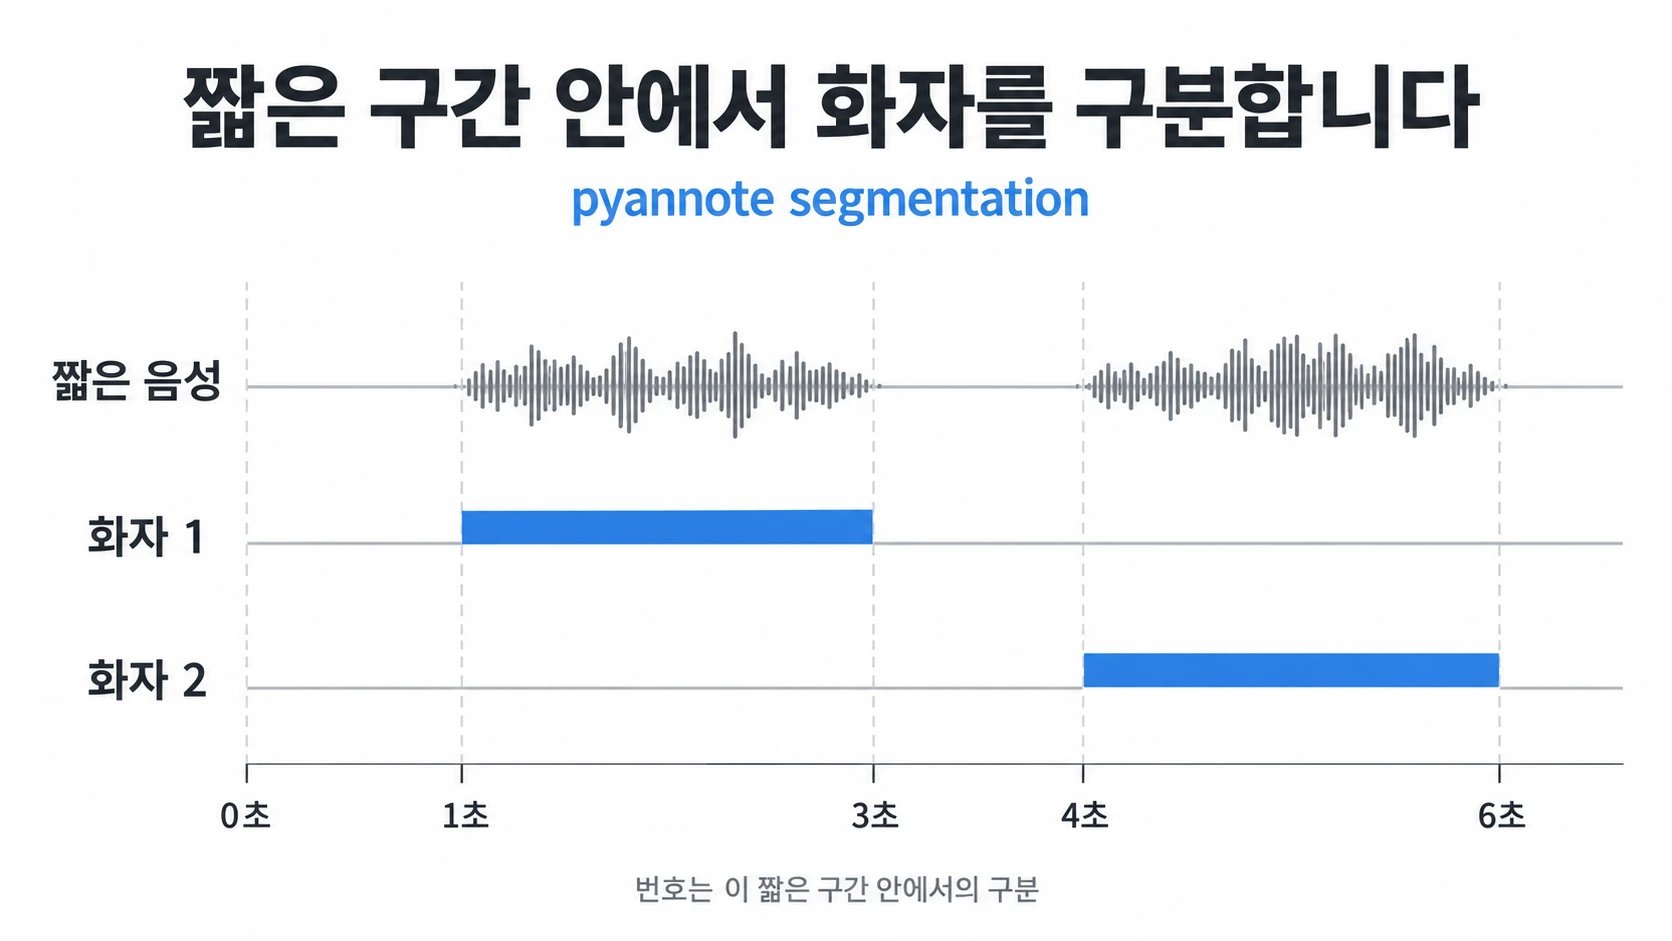
하지만, 이렇게 나눈 구간의 화자 번호가 회의 전체에서 같은 사람을 가리킨다는 보장은 없습니다.
앞부분의 발언과 한참 뒤의 발언이 같은 사람의 목소리인지도 비교해야 합니다.
떨어진 발언을 한 명의 발언으로 묶기
한 사람이 회의 초반에 말하고, 다른 사람의 이야기를 들은 뒤 다시 말할 수도 있습니다.
두 발언이 떨어져 있어도 같은 사람의 말로 연결해야 합니다.
이때 목소리의 특징을 뽑는 모델이 ERes2Net입니다.
발언의 음성을 숫자 배열로 바꾸며, 이를 화자 임베딩이라고 합니다.
이후에는 이 숫자 배열을 비교해 목소리 특징이 비슷한 발언끼리 묶습니다. ERes2Net이 특징을 추출하고, 그 특징으로 같은 화자를 묶는 계산은 별도로 수행하는 것입니다.
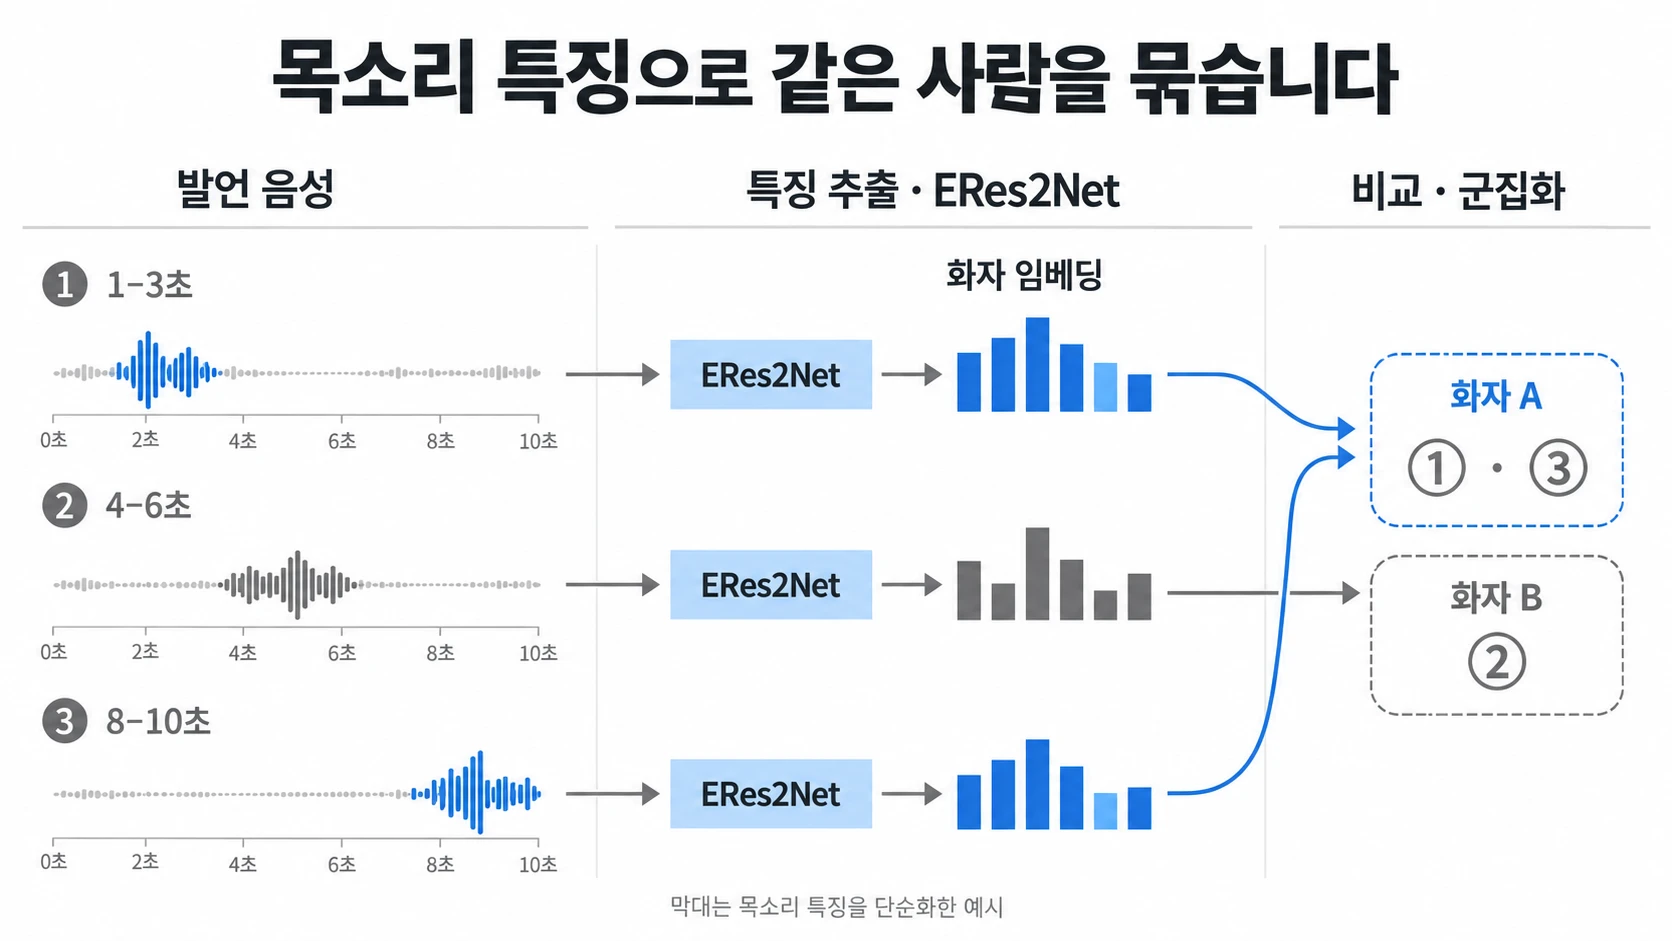
이렇게 회의 안에서 서로 다른 목소리를 A, B처럼 구분합니다.
같은 시간을 기준으로 연결합니다
이제 한쪽에는 단어와 시각이 있고, 다른 쪽에는 화자별 발언 구간이 있습니다.
두 결과를 연결하려면 어떻게 해야 할까요?
단어가 나온 시간과 화자가 말한 시간이 겹치는지 확인합니다.
설명을 위한 예시는 다음과 같습니다.
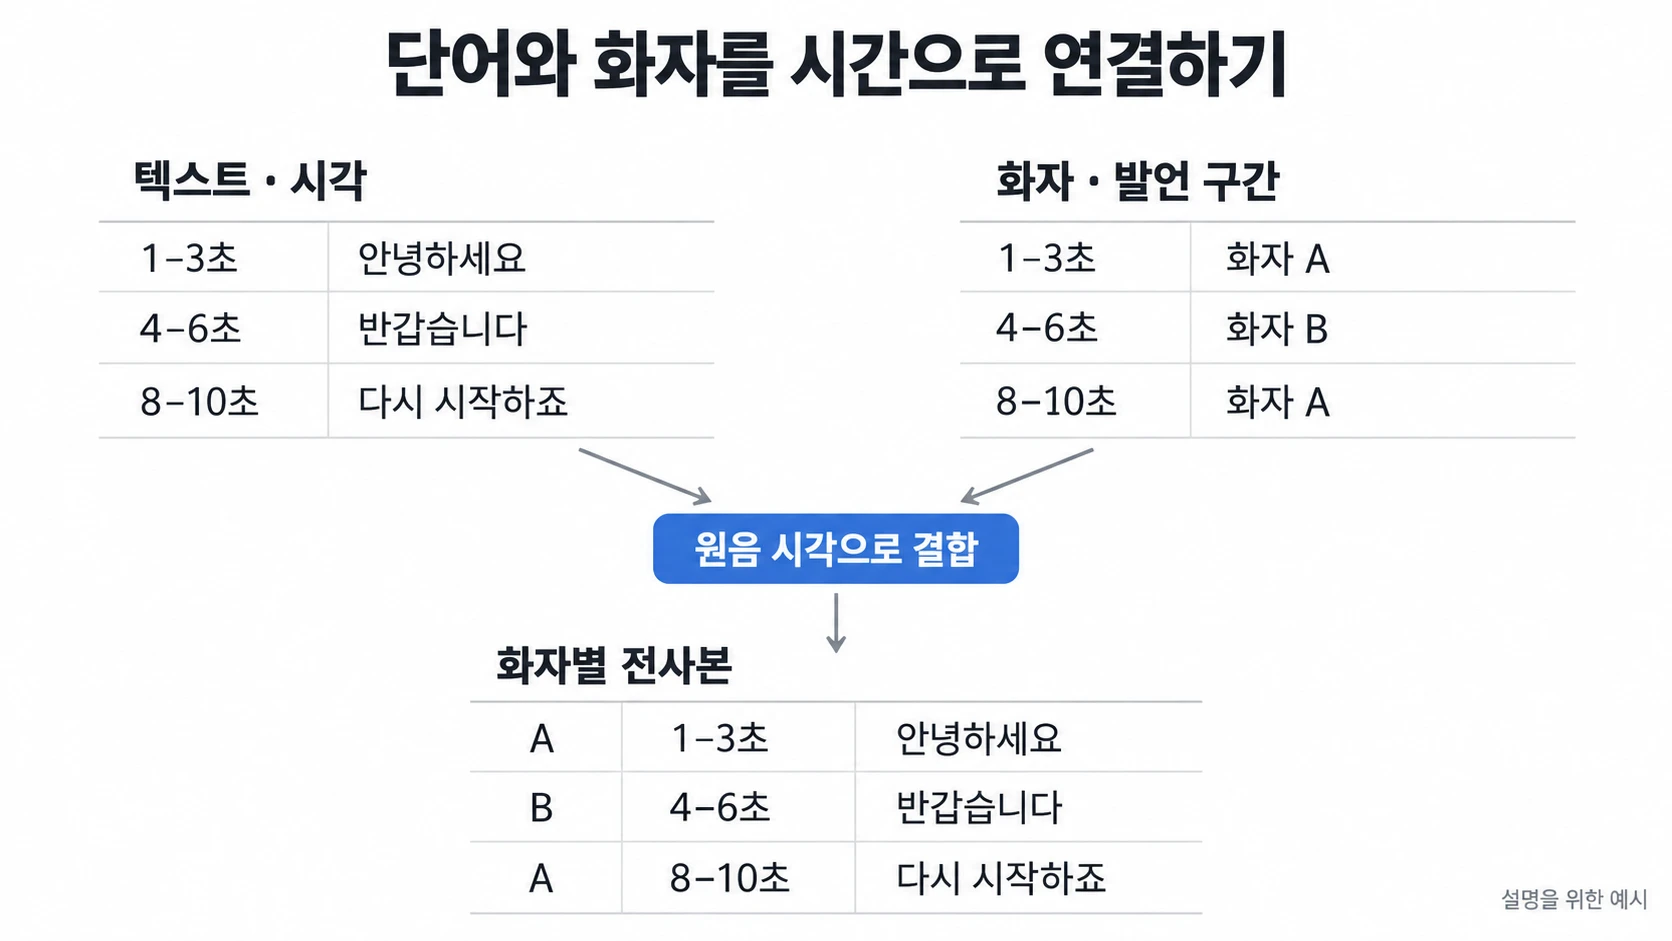
이때 두 시각은 모두 원음을 기준으로 해야 합니다.
침묵을 덜어낸 음성의 7초가 원음에서는 10초일 수도 있기 때문입니다.
Knot은 단어의 시각을 원음 기준으로 맞춘 뒤 화자 정보와 연결합니다. 이렇게 누가, 언제, 무슨 말을 했는지가 담긴 전사본을 만듭니다.
3. 초기 전사 결과와 개선 시도
역할에 맞는 모델을 연결한 뒤에는 실제 회의를 얼마나 잘 옮기는지 확인해야 했습니다.
사용할 수 없는 수준의 모델 성능
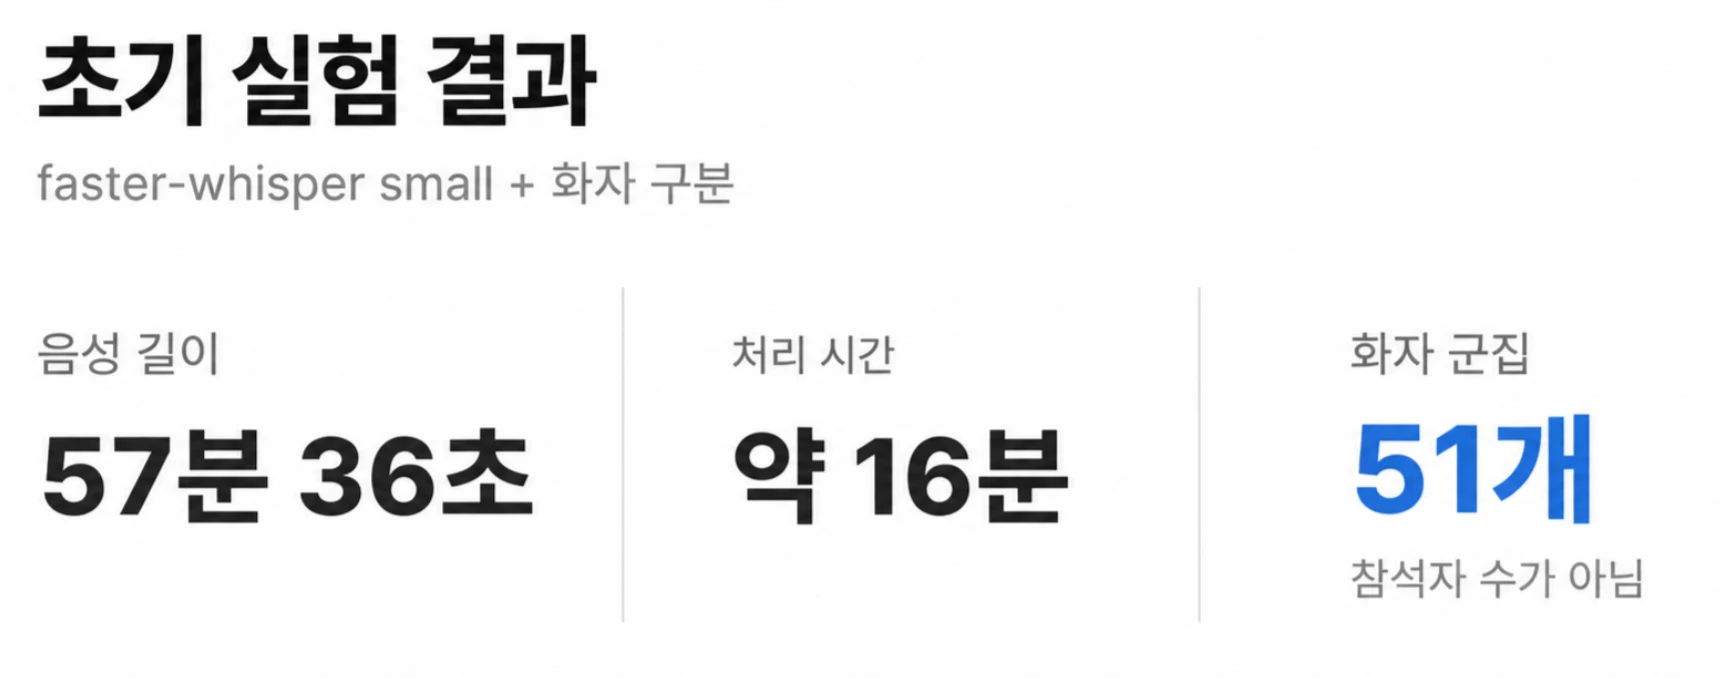
초기에는 faster-whisper small 모델과 sherpa 기반 화자 구분을 사용했습니다.
초기 실험에서는 57분 36초짜리 회의를 전사하는 데 약 16분이 걸렸습니다.
프로그램은 끝까지 실행됐고 전사 파일도 만들어졌습니다.
하지만 결과를 읽어보니 그대로 사용하기는 어려웠습니다.
5명 내외가 참가한 회의에서 화자 군집이 51개로 나뉘어 있었습니다.
같은 사람의 발언을 여러 화자로 나누고 있어, 누가 한 말인지 구분하기 어려웠습니다.
전사 퀄리티에도 문제가 있었습니다.
기술 용어가 어색했고, 문맥을 복원하기 어려운 표현이 남았습니다.
다음은 당시 출력의 일부입니다.
[00:00:04.160 - 00:00:10.580] Speaker 1
분석이요? 이 케이크입니다 루트롤이라는 거리 이런 거를

[00:00:13.070 - 00:00:19.070] Speaker 1
CRU들의 카라멜으로 된다고 생각을 하고요 그러니까 예를 들어 팀의 API에서 경로를 받아와

[00:00:19.750 - 00:00:21.850] Unknown
어쩌면 어쩌면 어쩌고 루트로
이 실험에는 정답 전사문이 없어서 각 표현의 원래 발언을 확정할 수는 없었지만, 이 출력만으로는 회의에서 어떤 기술과 동작을 설명했는지 이해하기 어려웠습니다.
설정을 바꿔 결과가 달라져도, 실제로 좋아졌는지 판단하려면 원음과 비교할 기준이 필요했습니다.
직접 듣고 정답 만들기
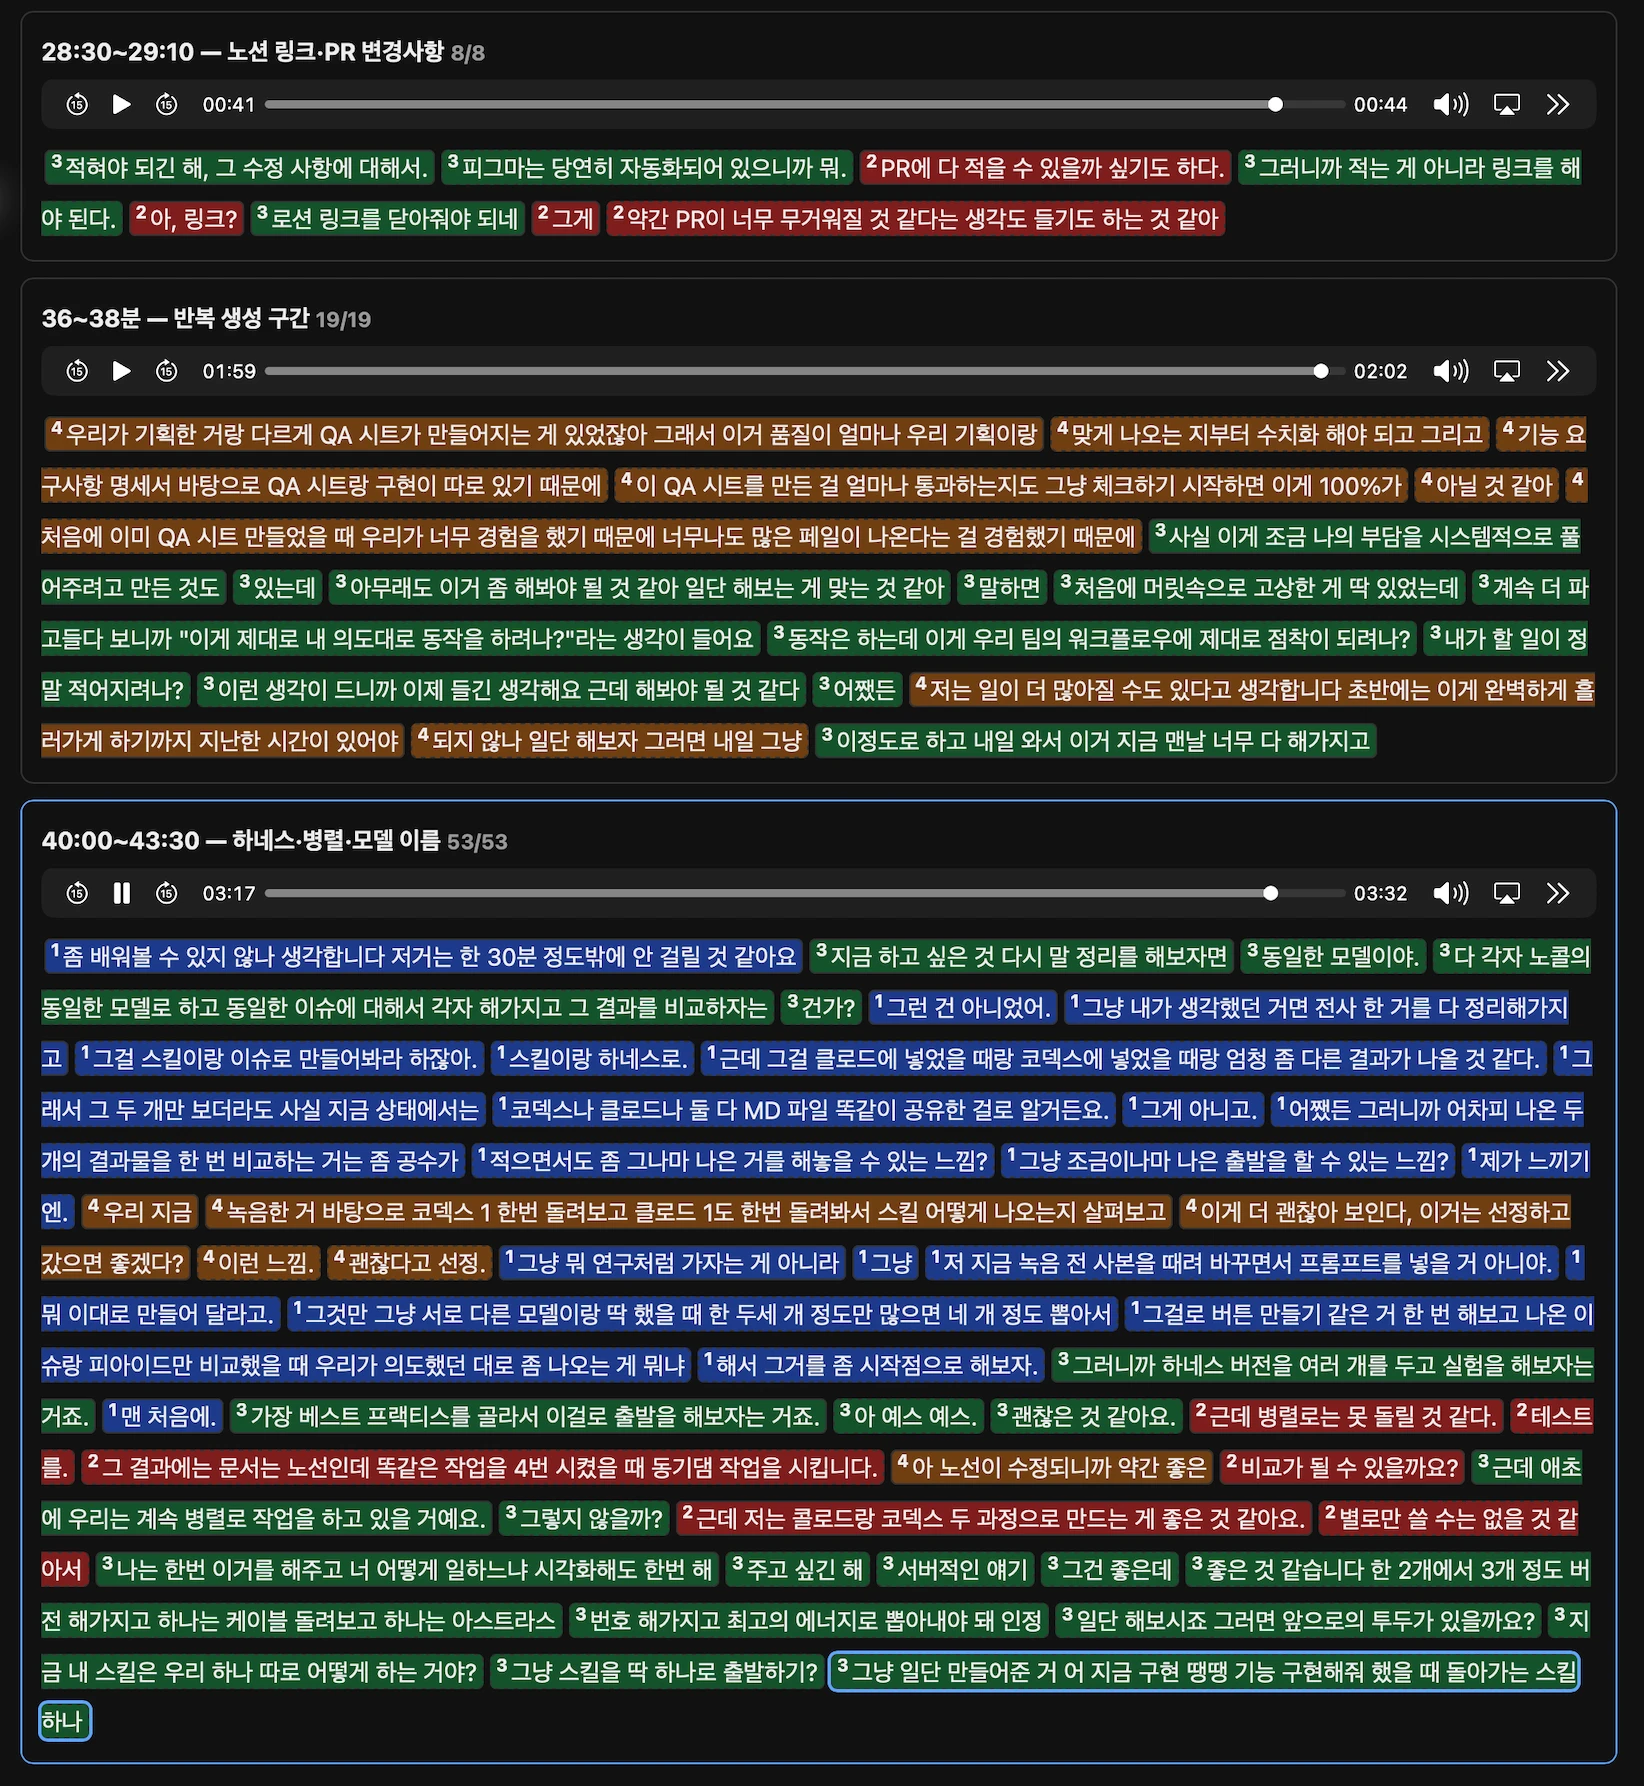
그래서 녹음을 들으며 직접 전사문을 수정했습니다.
약 10시간의 회의 음성을 직접 들으며, 누가 말했는지, 뭐라고 말했는지 구별했습니다.
알아듣기 어려운 말은 추측해서 채우지 않고, 기술 용어와 숫자, 부정 표현처럼 잘못 적히면 회의의 의미가 달라질 수 있는 부분을 따로 확인했습니다.
용어집과 화자 수를 제공한다면?
전사문과 화자 배정을 직접 확인하면서, 모델에 회의에 대한 정보를 미리 제공하면 결과가 달라질지도 궁금해졌습니다.
먼저 회의에서 사용하는 단어를 용어집으로 제공했습니다.
OAuth, GitHub, 리다이렉트처럼 개발 회의에서 자주 나오는 표현이었습니다.
정답 문장을 알려주는 대신, 어떤 단어가 나올 수 있는지 힌트를 주는 방식입니다.
화자 구분에는 실제로 말하는 사람이 몇 명인지도 알려줬습니다.
모델이 인원을 모르는 상태에서 목소리를 구분하는 것과, 화자 수를 알고 구분하는 것의 차이를 확인해봤습니다.
용어집과 화자 수를 제공했을 때는 전사 품질과 화자 구분이 눈에 띄게 좋아졌습니다.
모델을 바꾸는 것 외에도 입력할 정보를 조정하는 방법으로 결과를 개선할 수 있었습니다.
그러나,
이 방식을 서비스에 그대로 적용하지는 않았습니다.
실험에서는 제가 용어집을 준비하고 화자 수를 입력하면 됐습니다.
하지만 서비스에서는 사용자가 녹음할 때마다 같은 과정을 거쳐야 했습니다.
회의를 녹음하려고 들어왔는데, 먼저 회의에 나올 단어를 정리하고 화자 수까지 입력해야 하는 것은 번거로웠습니다.
전사 품질이 좋아지더라도 녹음을 시작하기 전에 준비할 일이 많아져 UX를 해치는 방식은 피하고 싶었습니다.
그래서 사용자가 용어집과 화자 수를 직접 입력하는 과정을 기본 사용 흐름에 넣지는 않았습니다.
이후에는 사전 입력 없이도 전사와 화자 구분의 품질을 높이는 방향으로 개선을 이어갔습니다.
4. 현재 Knot의 전사 구성
2026년 10월 30일 기준 Knot의 전사 구성은 다음과 같습니다.
| 역할 | 모델 | 실행 도구 |
|---|---|---|
| 말소리가 있는 구간 찾기 | Silero VAD v5.1.2 | whisper.cpp |
| 음성을 글로 옮기기 | Whisper large-v3, Q5_0 양자화 | whisper.cpp |
| 화자 활동 분석 | pyannote segmentation 3.0 | sherpa-onnx |
| 목소리 특징 추출 | ERes2Net | sherpa-onnx |
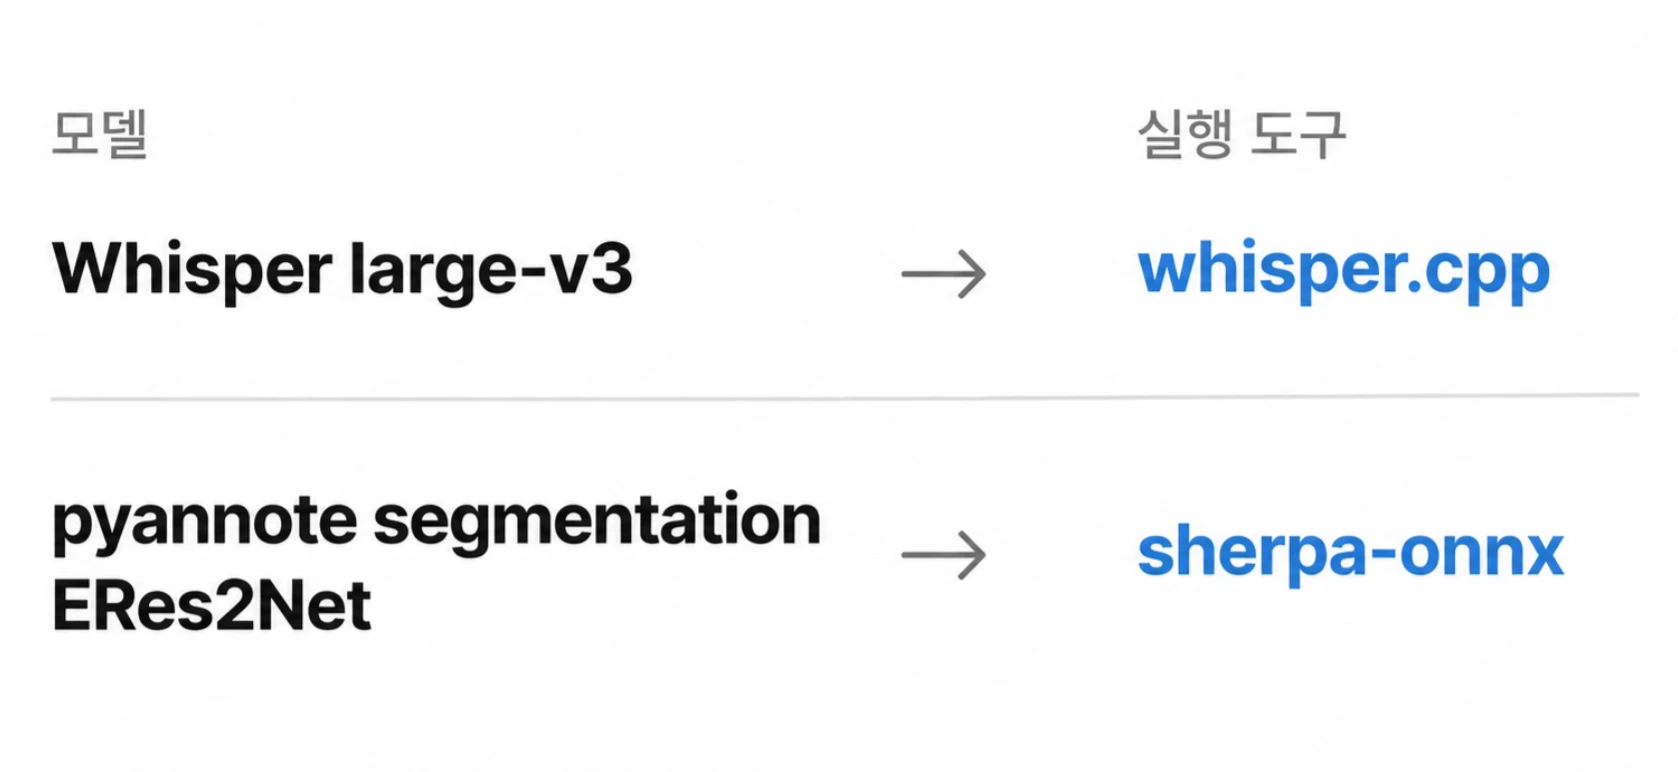
이 모델들은 맥미니의 AI 서버에서 실행합니다.
브라우저가 음성을 수집해 업로드하면, API 서버가 처리할 작업을 관리하고 AI 서버에 전달합니다.
결과를 받아 저장하고 후속 문서 생성으로 연결하는 일은 API 서버에서 맡습니다.
이번 글에서는 로컬 모델을 선택한 이유와 전사 구조, 초기 개선 시도를 정리했고, 다음 글에서는 전사 오류와 화자 구분 문제를 확인하고 개선해간 과정을 다뤄보겠습니다.