[Knot] 녹음 유실 해결하기
이 글의 목차6개
문제점
전사 품질을 개선하는 동안, 사용자에게서 녹음 자체가 유실되었다는 피드백을 받았습니다.
실제로 브라우저 종료 등으로 녹음을 잃은 사례가 많았고, 이후 다시 방문하지 않은 사용자도 확인했습니다.
녹음 서비스에서 녹음 원본 파일이 사라진다는 것은 정말 치명적인 문제였습니다.
사용자가 다음 회의도 Knot에 맡기려면 녹음 결과가 남는다는 믿음이 먼저 필요하다고 생각했습니다.
그래서 녹음이 끝났을 때 저장하던 방식을 바꾸고, 저장한 음성으로 실패한 처리를 다시 시작할 수 있게 만들었습니다.
1. 녹음이 끝나기 전에 저장
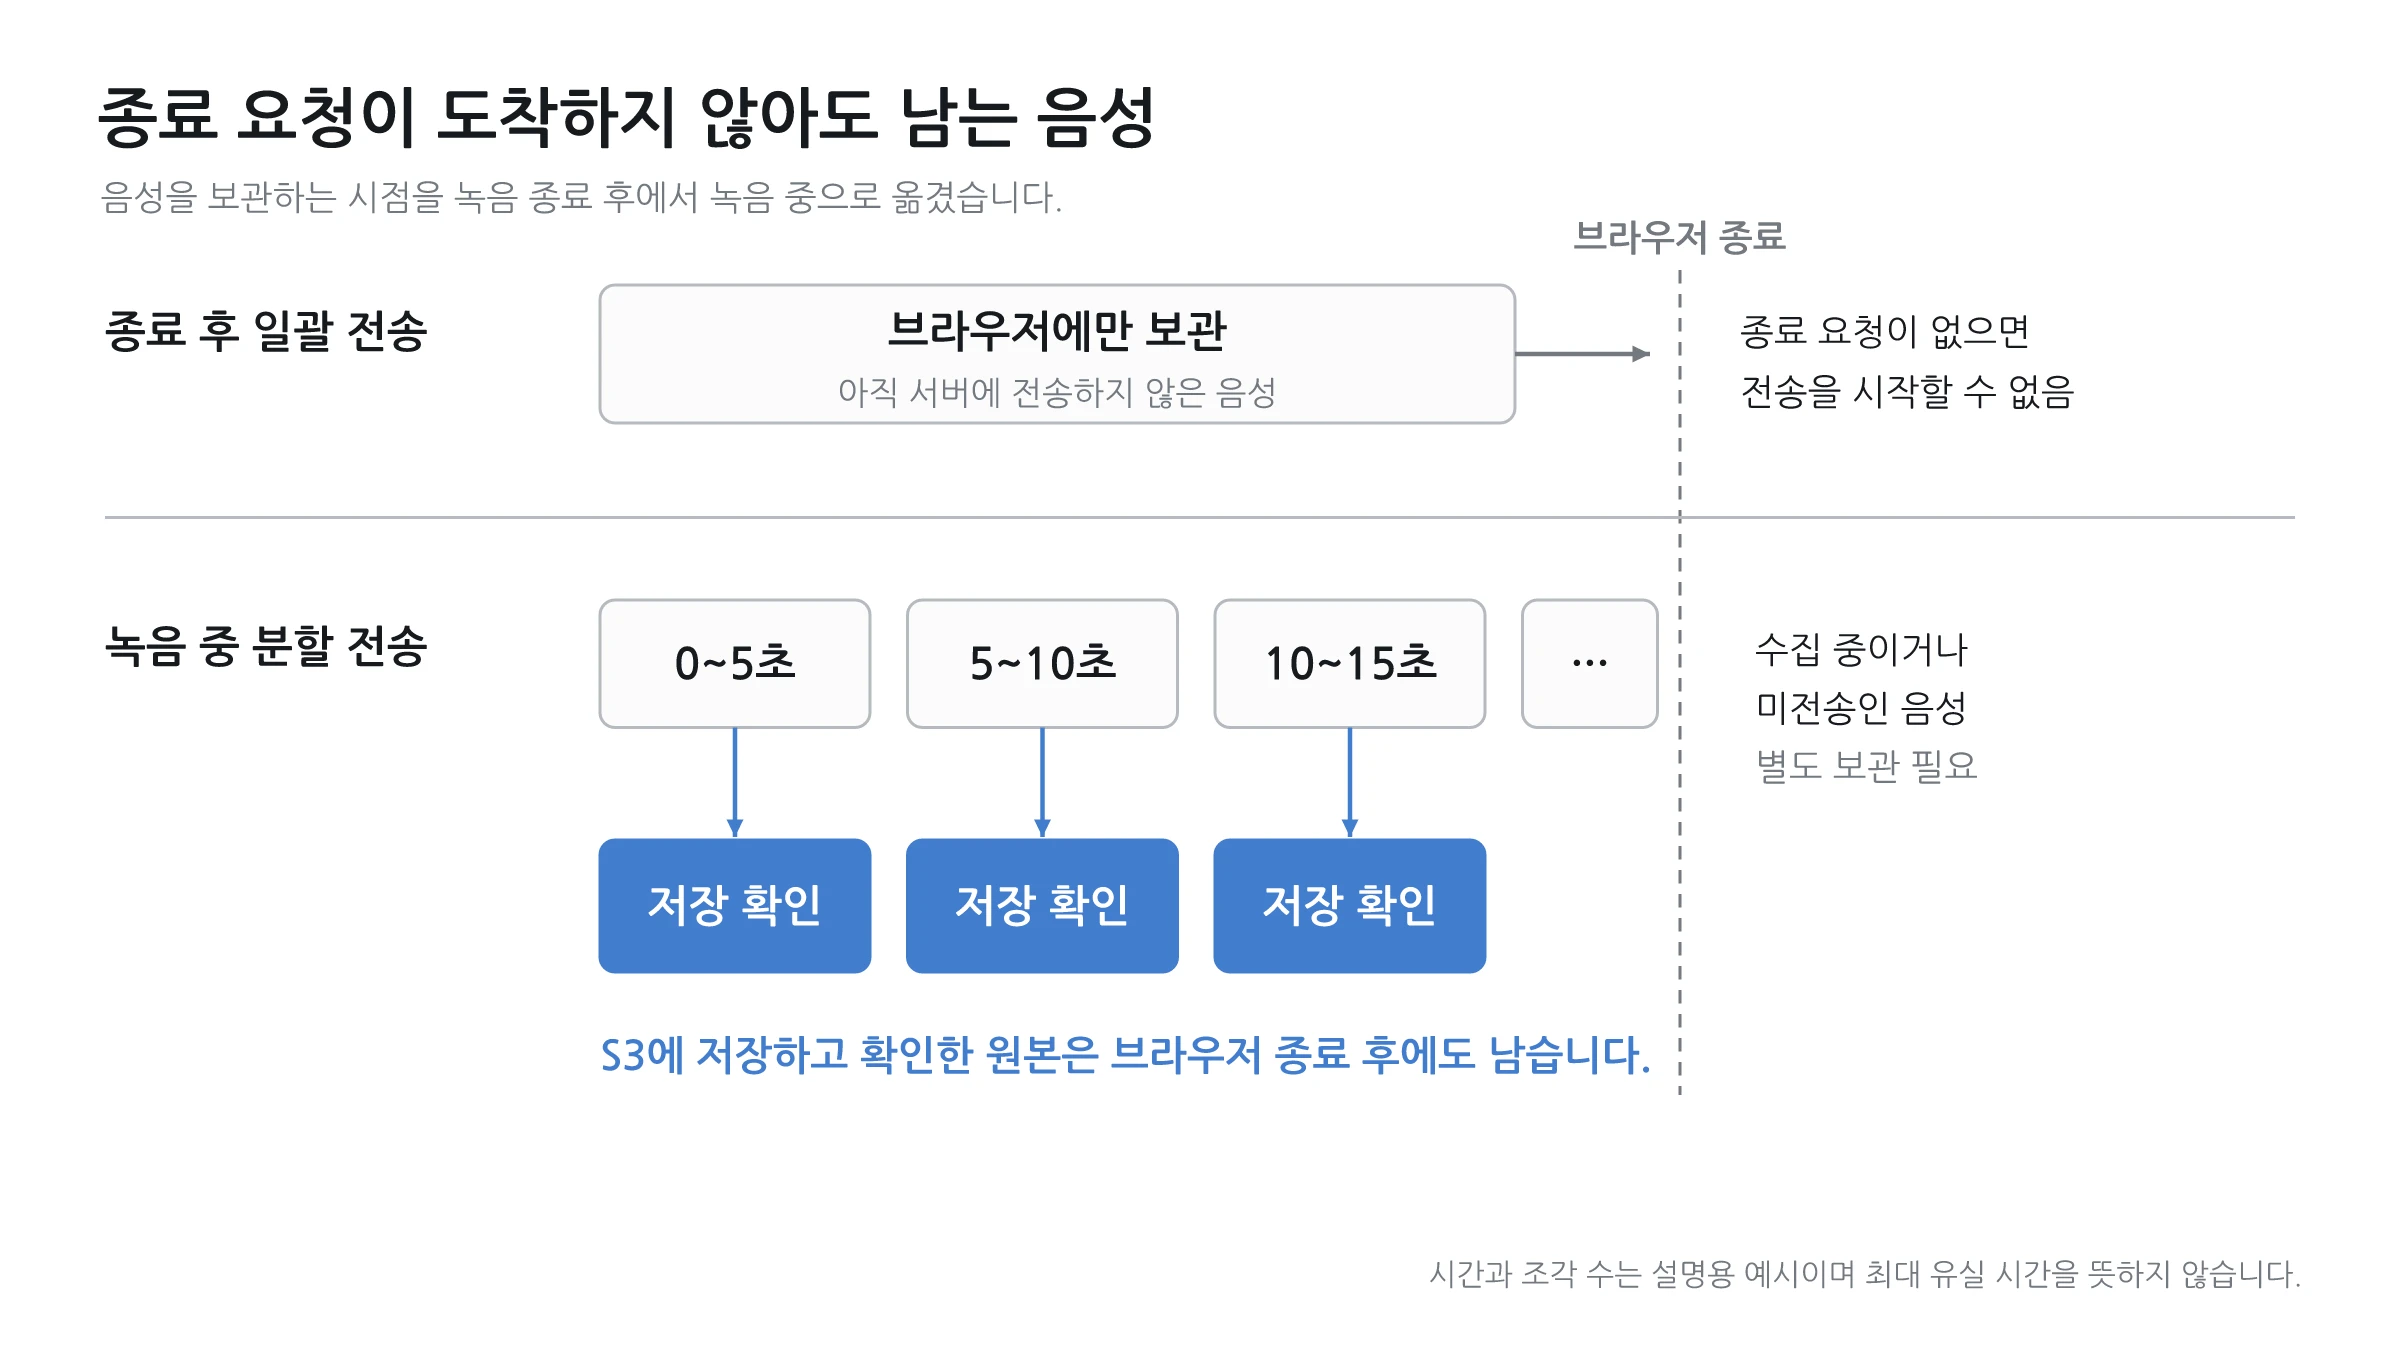
기존에는 브라우저가 음성을 모았다가 녹음 종료 후 한 번에 전송했습니다.
그런데 업로드 전에 탭이 닫히면 파일이 유실되어 서버에는 아무것도 남지 않았습니다.
사용자가 종료 버튼을 누르지 못해도, 그 전까지의 녹음 음성은 남아있도록 개선해야 했습니다.
그래서 브라우저에서 5초마다 음성을 나눠 S3에 저장하도록 바꿨습니다. 음성은 순서대로 이어 붙일 수 있는 PCM 형식으로 받았습니다.
2. 실제로 저장된 파일인지 확인
파일은 브라우저가 S3로 직접 보냈습니다. 백엔드가 큰 음성 파일을 받아 다시 전송하는 부담을 줄이기 위해서였습니다.
그렇다면 브라우저가 업로드를 끝냈다고 알려주면 바로 전사를 시작해도 될까요?
예약한 파일과 다른 내용이 올라오거나, 같은 요청이 다시 들어올 수 있었습니다. 그래서 업로드 예약과 저장 완료를 구분하고, 서버에서 실제 파일을 확인했습니다.
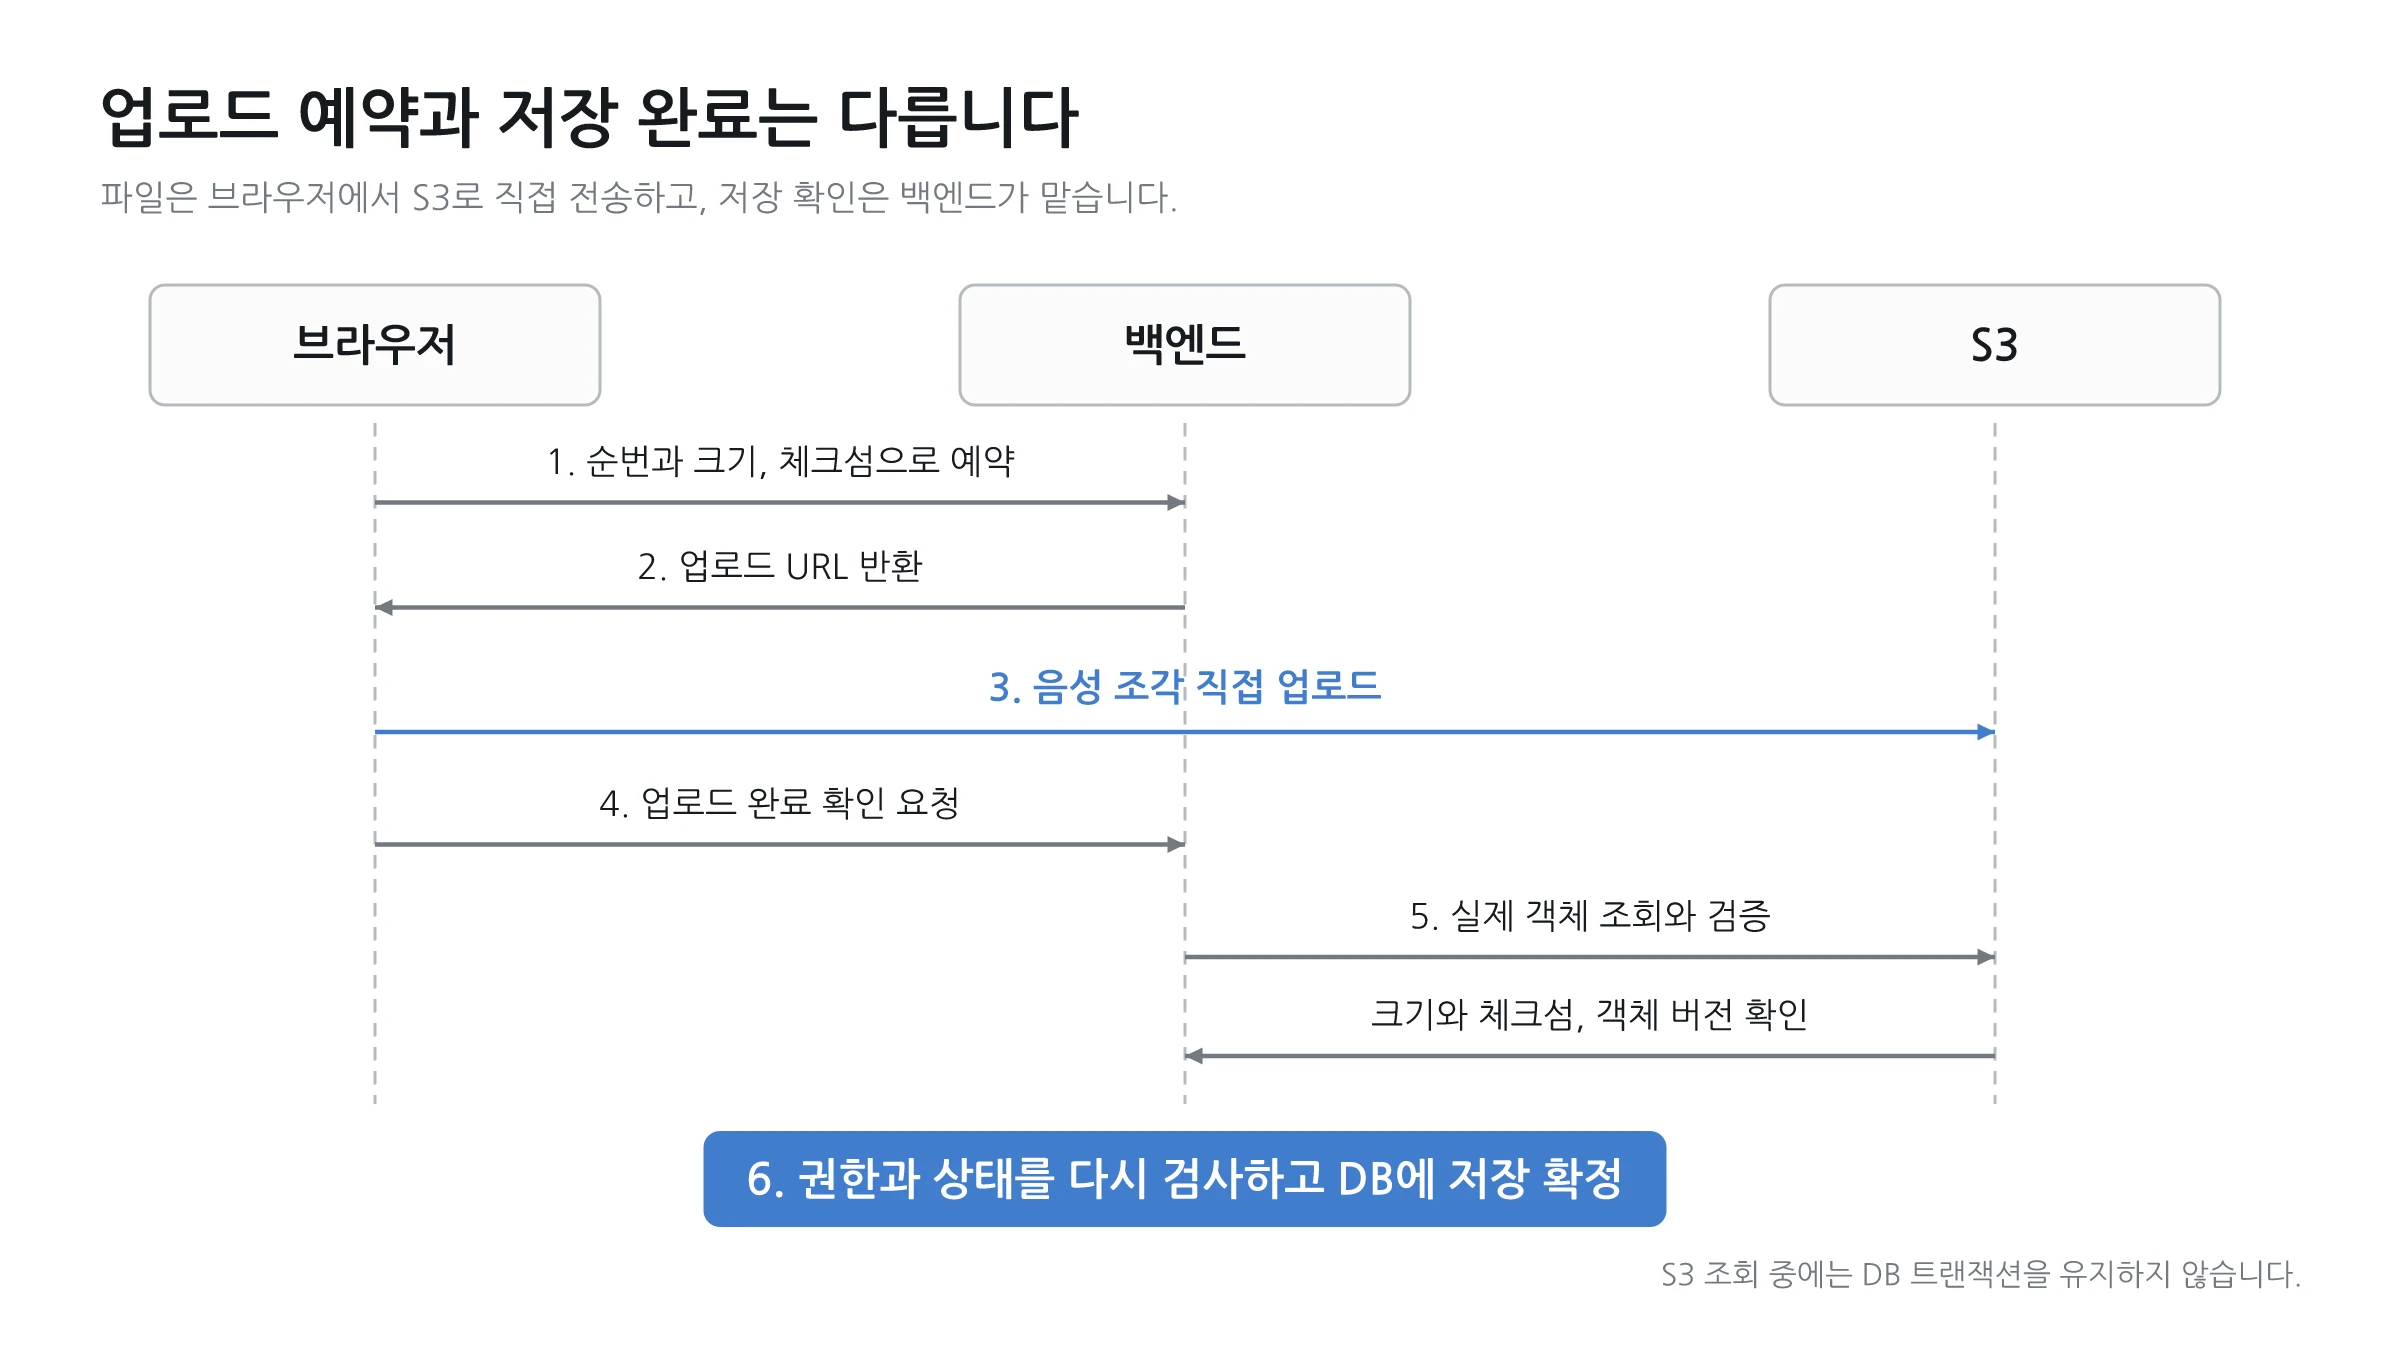
브라우저는 먼저 순번과 음성의 위치, 크기, SHA-256 체크섬으로 업로드를 예약합니다. 완료 요청이 오면 백엔드는 S3 객체의 크기와 체크섬을 비교하고, 일치한 파일의 버전을 DB에 저장합니다.
파일의 버전까지 남긴 이유는 같은 경로의 내용이 나중에 바뀔 수 있기 때문입니다. 전사할 때도 그 버전을 지정해 저장을 확인했던 원본을 읽도록 했습니다.
같은 순번에 같은 내용으로 다시 요청하면 기존 결과를 반환했습니다. 같은 순번이라도 내용이 다르면 거절해, 재시도 때문에 조각이 늘어나거나 다른 음성이 섞이지 않게 했습니다.
S3를 기다리는 동안 상태가 바뀐다면?
S3 조회를 DB 트랜잭션 안에서 기다리면 외부 응답이 늦어지는 동안 잠금도 오래 유지될 수 있었습니다.
그래서 S3 조회는 트랜잭션 밖에서 실행했습니다. 조회 후 저장을 확정할 때는 녹음 상태와 제어 권한을 다시 확인했습니다. 처음 요청을 받았을 때 유효했더라도, 기다리는 동안 상태가 바뀔 수 있기 때문입니다.
코드에서도 확인 준비, S3 조회, 저장 확정을 나눴습니다.
@Transactional(propagation = Propagation.NOT_SUPPORTED)
public RecordingAudioChunkCompletionResult complete(
        long workspaceId, long memberId, long recordingId,
        int sequence, RecordingControlCommand command
) {
    RecordingAudioChunkConfirmation preparation = transaction.prepareConfirmation(
            workspaceId, memberId, recordingId, sequence, command);
    if (preparation.completed() != null) {
        return preparation.completed();
    }
    StoredAudioChunk stored = storage.findStoredObject(preparation.storageKey());
    return transaction.confirmStored(
            workspaceId, memberId, recordingId, sequence, command, stored);
}
3. 실패한 처리를 이어받기
원본이 남아 있어도 AI 서버가 멈추거나, 전사는 끝났지만 결과를 저장하지 못할 수 있었습니다. 이때 사용자가 다시 녹음해야 한다면 원본을 보존한 의미가 없다고 생각했습니다.
처리할 작업과 진행 상태를 DB에 기록하고, 실행 시도마다 ID를 부여했습니다. AI 응답을 놓쳤을 때는 같은 시도의 상태와 결과부터 조회했습니다. 이미 끝난 결과는 가져와 저장하고, AI에 작업이 없다는 것이 확인되면 같은 원본으로 다시 요청했습니다.
응답이 없다고 바로 새 작업을 만들면, AI가 이미 진행 중인 전사까지 중복 실행할 수 있었기 때문입니다.
멈췄던 작업자가 뒤늦게 돌아온다면?
작업자에게 소유권과 만료 시각을 부여하고, 갱신이 끊기면 다른 작업자가 이어받도록 했습니다.
그런데 A가 멈춰 B에게 작업을 넘긴 뒤, A가 뒤늦게 결과를 가져오는 경우도 생각해야 했습니다. 이때 둘 다 저장할 수 있다면 같은 작업의 결과가 충돌할 수 있었습니다.
그래서 작업을 넘길 때마다 세대 번호를 바꿨습니다. 결과를 저장할 때는 현재 소유자와 세대 번호가 모두 맞아야 합니다.
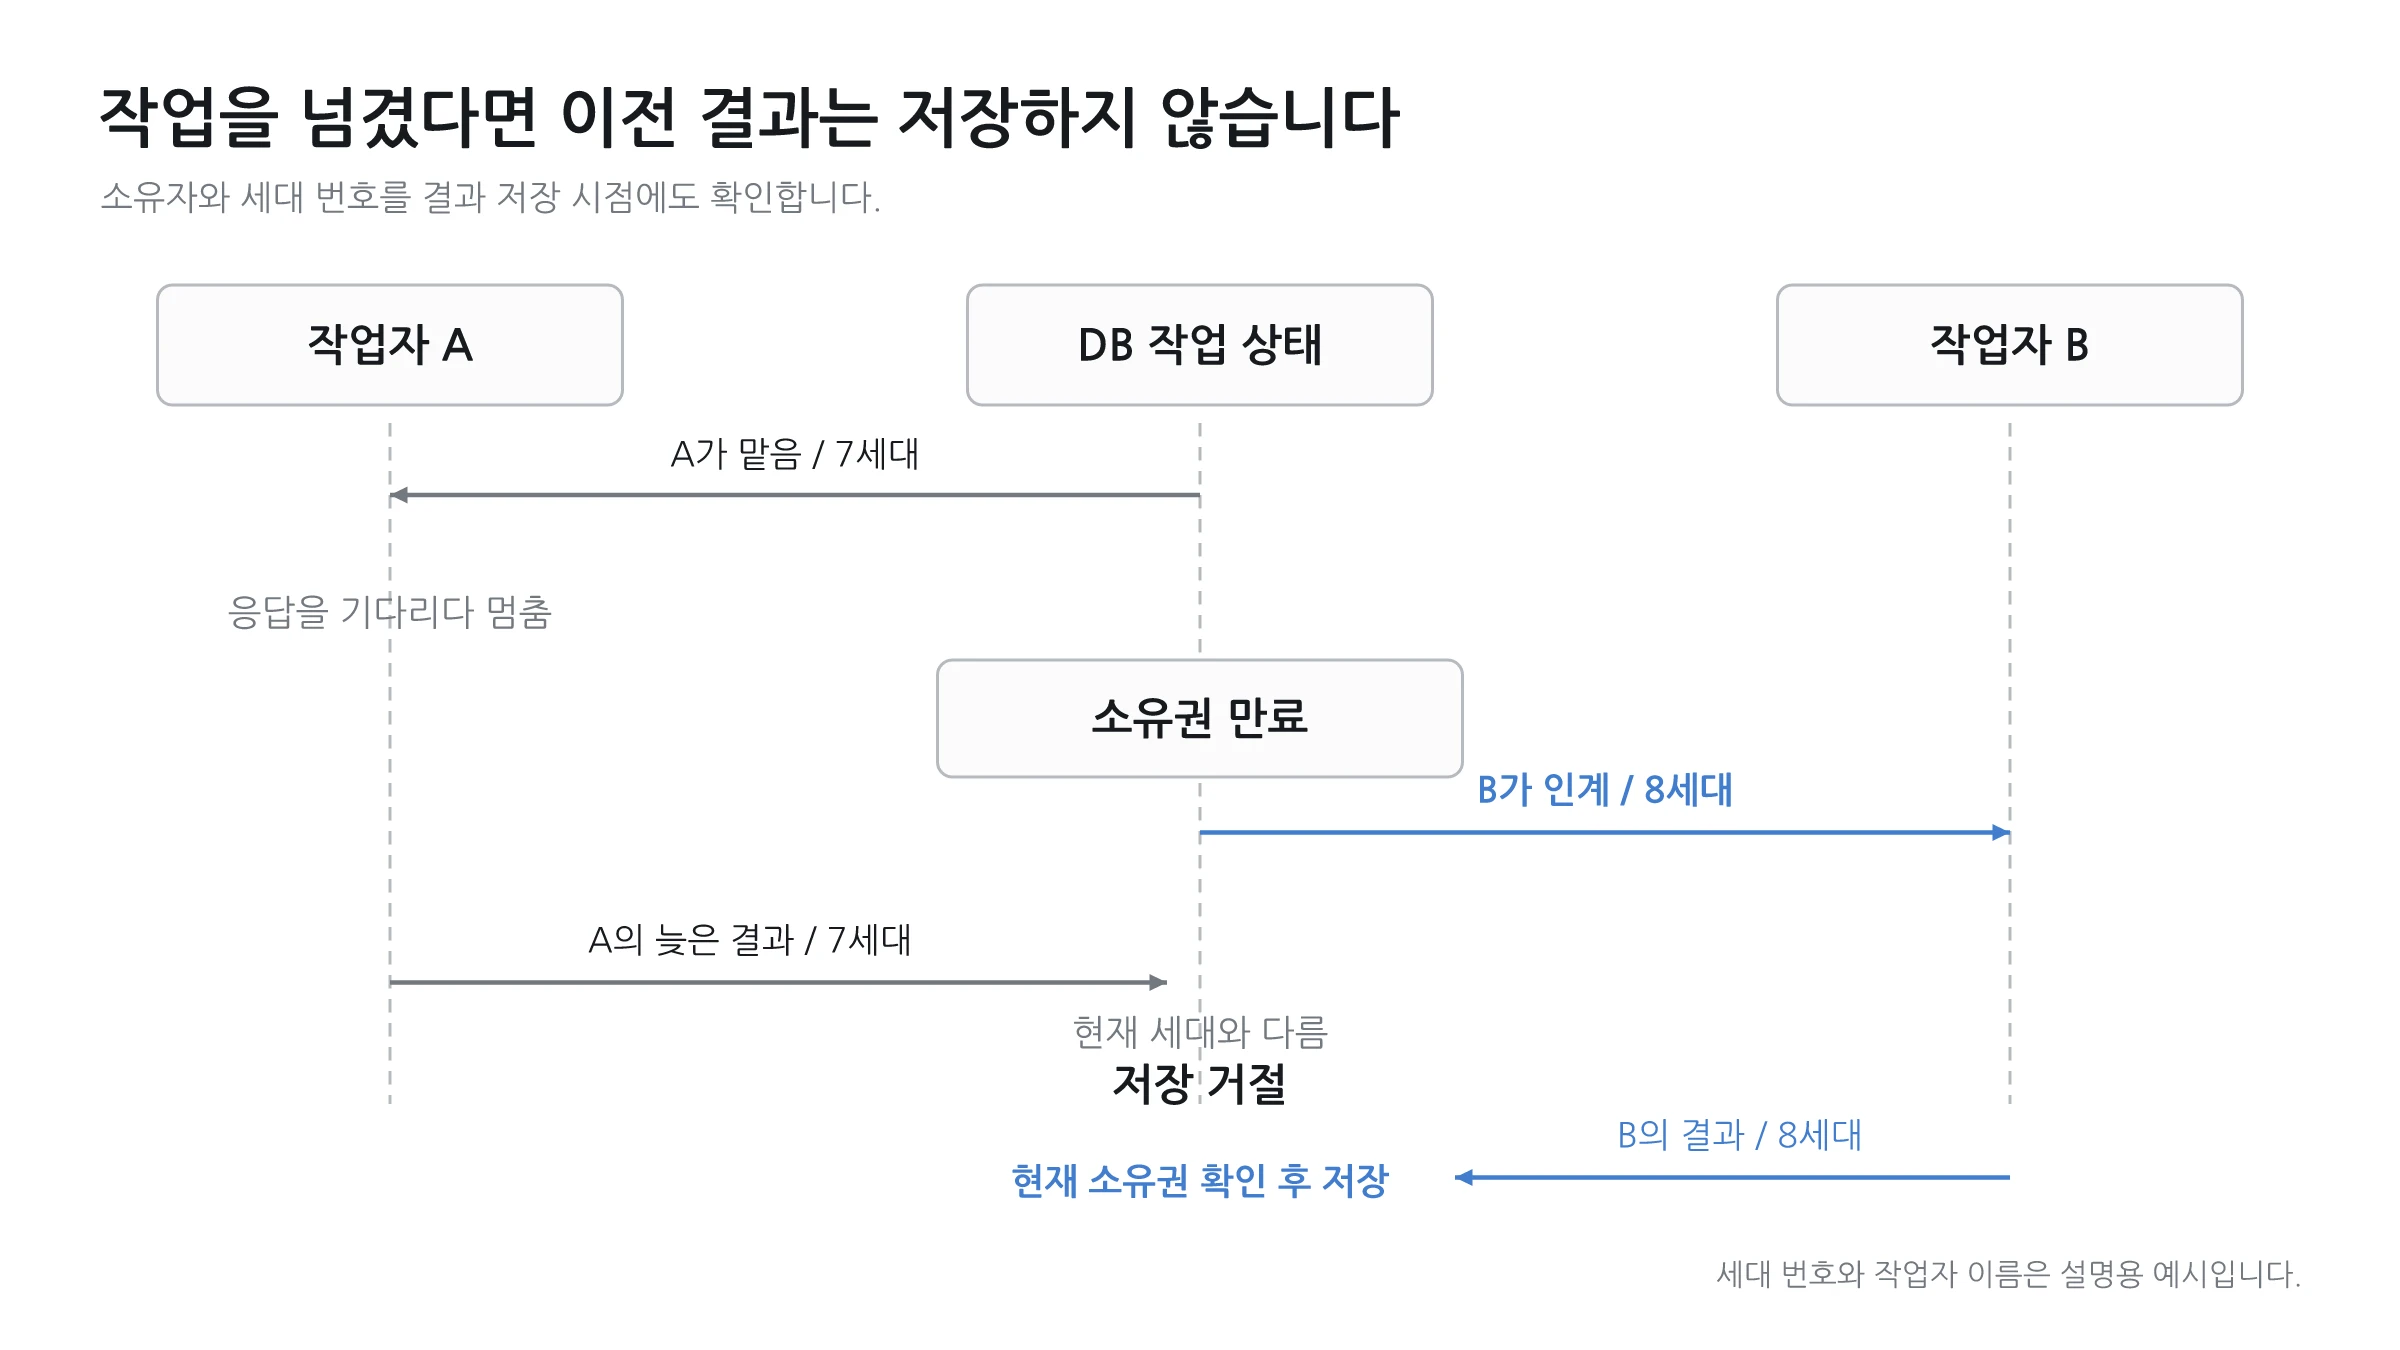
B가 이어받은 뒤에는 A의 늦은 저장을 거절합니다.
결과를 반영하기 전에는 다음 조건을 확인합니다.
public boolean isOwnedBy(UUID attempt, UUID owner, long epoch, Instant now) {
    return isProcessingAttempt(attempt)
            && owner != null && owner.equals(ownerToken)
            && epoch == claimEpoch
            && leaseUntil != null && now.isBefore(leaseUntil);
}
전사 저장과 다음 문서 생성 접수도 하나의 트랜잭션으로 묶었습니다. 전사만 저장되고 문서 생성이 빠져 사용자가 결과를 기다리는 상태를 남기지 않기 위해서였습니다.