[Knot] 전사 시간 단축 과정
전사의 문제점
초기에 Knot 모델의 전사 시간은 1시간 음성당 약 15~35분이었습니다.
녹음의 발화량에 따라서 편차가 있었고, 평균적으로 25분 정도 걸렸습니다.
사용자가 1시간 동안 회의한 후에 20분 뒤에야 전사본을 받는 것이 유쾌한 경험은 아니라고 생각했습니다.
보통의 다른 전사 서비스는 녹음이 끝나고 30초 안에 전사를 완료시키니까요.
실제로 PostHog에서 사용자가 녹음 종료 후 약 1분을 기다리다가 페이지를 떠나는 모습을 반복해서 확인했습니다.
이 글에서는 Knot 모델의 전사 품질을 유지하면서 전사 시간을 단축할 방법에 대해 고민한 기록과 결과를 남겼습니다.
1. 녹음하면서 전사하기
앞선 변경으로 브라우저는 5초마다 음성을 S3에 저장하고 있었습니다.
회의가 끝나기 전에도 서버에는 이미 음성이 도착하고 있었습니다.
하지만, 녹음이 끝난 후에 모든 음성을 합쳐서 한 번에 전사하게 됩니다.
만약, 이 음성을 먼저 전사하면 어떨까요?
종료 후에는 마지막 구간을 처리하고, 앞서 만든 결과를 연결하는 일만 남길 수 있었습니다.
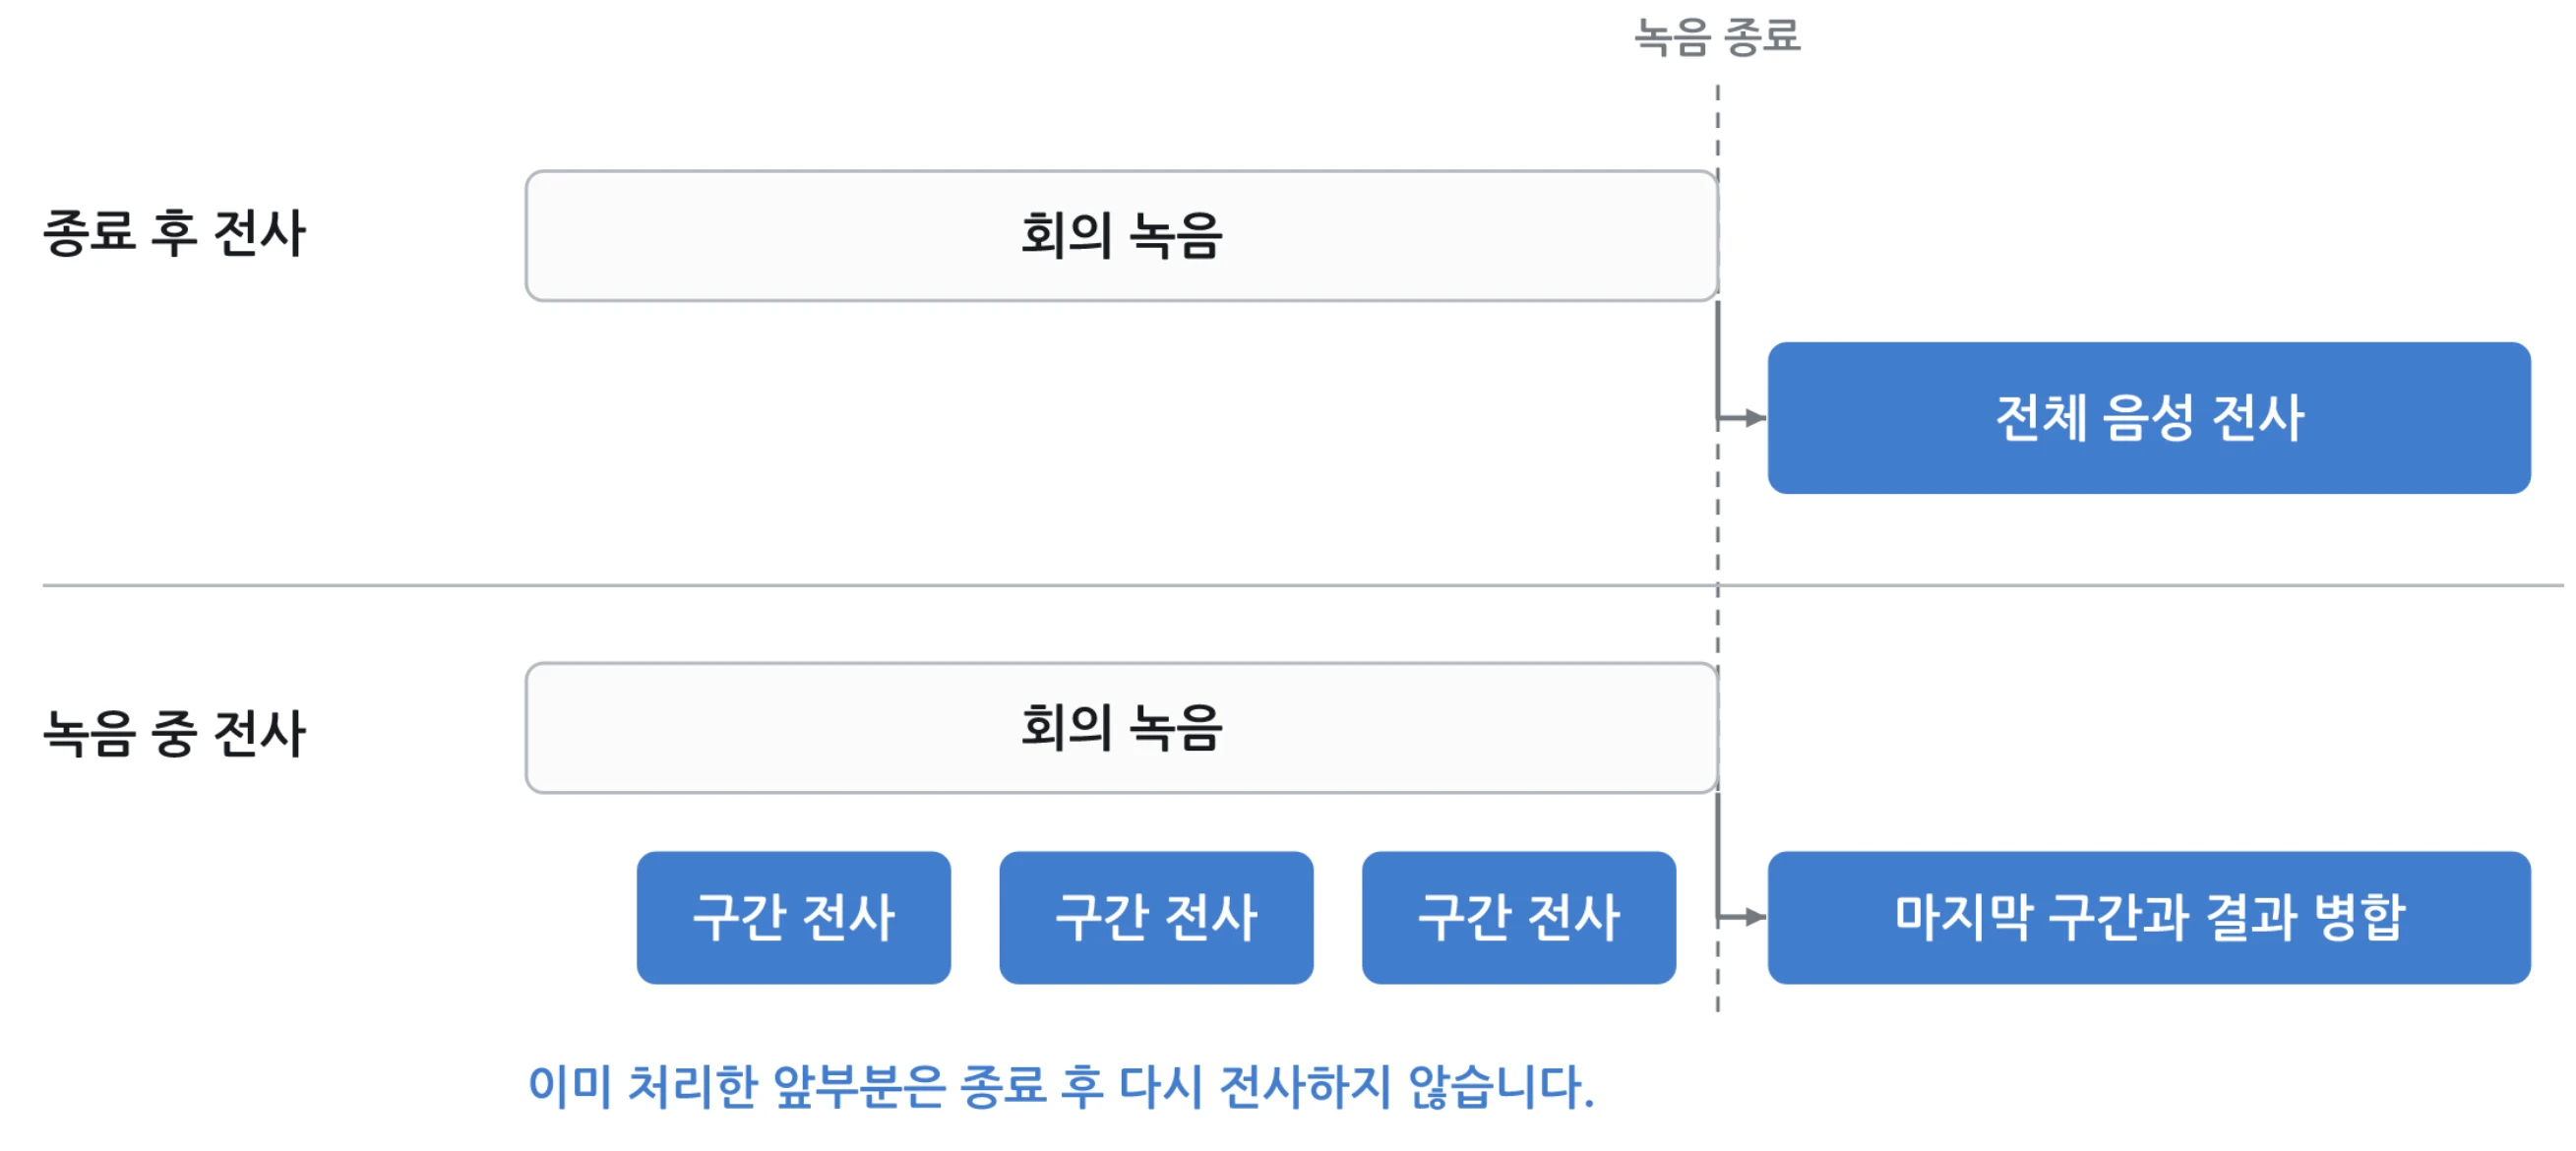
모델 자체가 빨라지지 않더라도, 사용자가 회의하는 동안 전사를 함께 처리할 수 있다면 녹음 종료 후 전사 결과가 나오는 시간을 획기적으로 줄일 수 있었습니다.
2. 얼마나 모아서 전사해야 할까?
저장을 5초마다 한다고 모델에도 5초씩 넣을 수는 없었습니다.
입력이 짧으면 말이 중간에서 잘리고 문맥도 부족해졌습니다.
반대로 너무 오래 모으면 전사를 시작하는 시점이 늦어졌습니다.
그래서 같은 회의의 정답이 있는 녹음본에 대해 구성을 비교했습니다. 30초, 2분, 3분으로 나누어 실험했습니다. 시간이 짧을수록 녹음이 종료된 후 결과가 빠르게 나오지만, 녹음이 절단되는 부분이 많아 오류율이 높다는 리스크가 존재했습니다.
| 입력 구성 | 문자 오류율 |
|---|---|
| 기존 30초 구간 구성 | 10.2% |
| 2분 구간 구성 | 8.3% |
| 같은 설정의 3분 구간 구성 | 8.2% |
30초 구성과 2분 구성은 문맥과 병합 방식도 달랐으므로, 차이를 모두 구간 길이의 효과로 볼 수는 없었습니다. 같은 설정으로 비교한 2분과 3분의 차이는 0.1%p였습니다.
2분과 3분의 오류율이 거의 같다면, 1분을 더 기다릴 만큼의 품질 차이는 없다고 판단하여, 2분 단위로 전사하기로 했습니다.
구간 경계에서 녹음이 잘리는 문제점
2분이 되는 시점에 문장도 끝난다는 보장은 없습니다.
예를 들어 사용자가 안녕하세요라고 말하는 도중에 구간이 나뉘면, 이전 입력에는 안녕까지만, 다음 입력에는 하세요만 들어갑니다. 각각 따로 전사하면 모델은 하나로 이어진 발화를 듣지 못합니다. 앞뒤 맥락이 부족해 다른 말로 인식하거나 일부를 빠뜨릴 수 있었습니다.
구간별 전사 결과를 나중에 붙이는 것만으로는 이미 잘못 인식한 말을 되돌리기 어려웠습니다. 다음 구간을 전사할 때, 잘린 말의 앞부분도 함께 들려줘야 한다고 생각했습니다.
그래서 두 번째 구간부터는 새 음성 2분에 직전 10초를 겹쳐 넣었습니다.
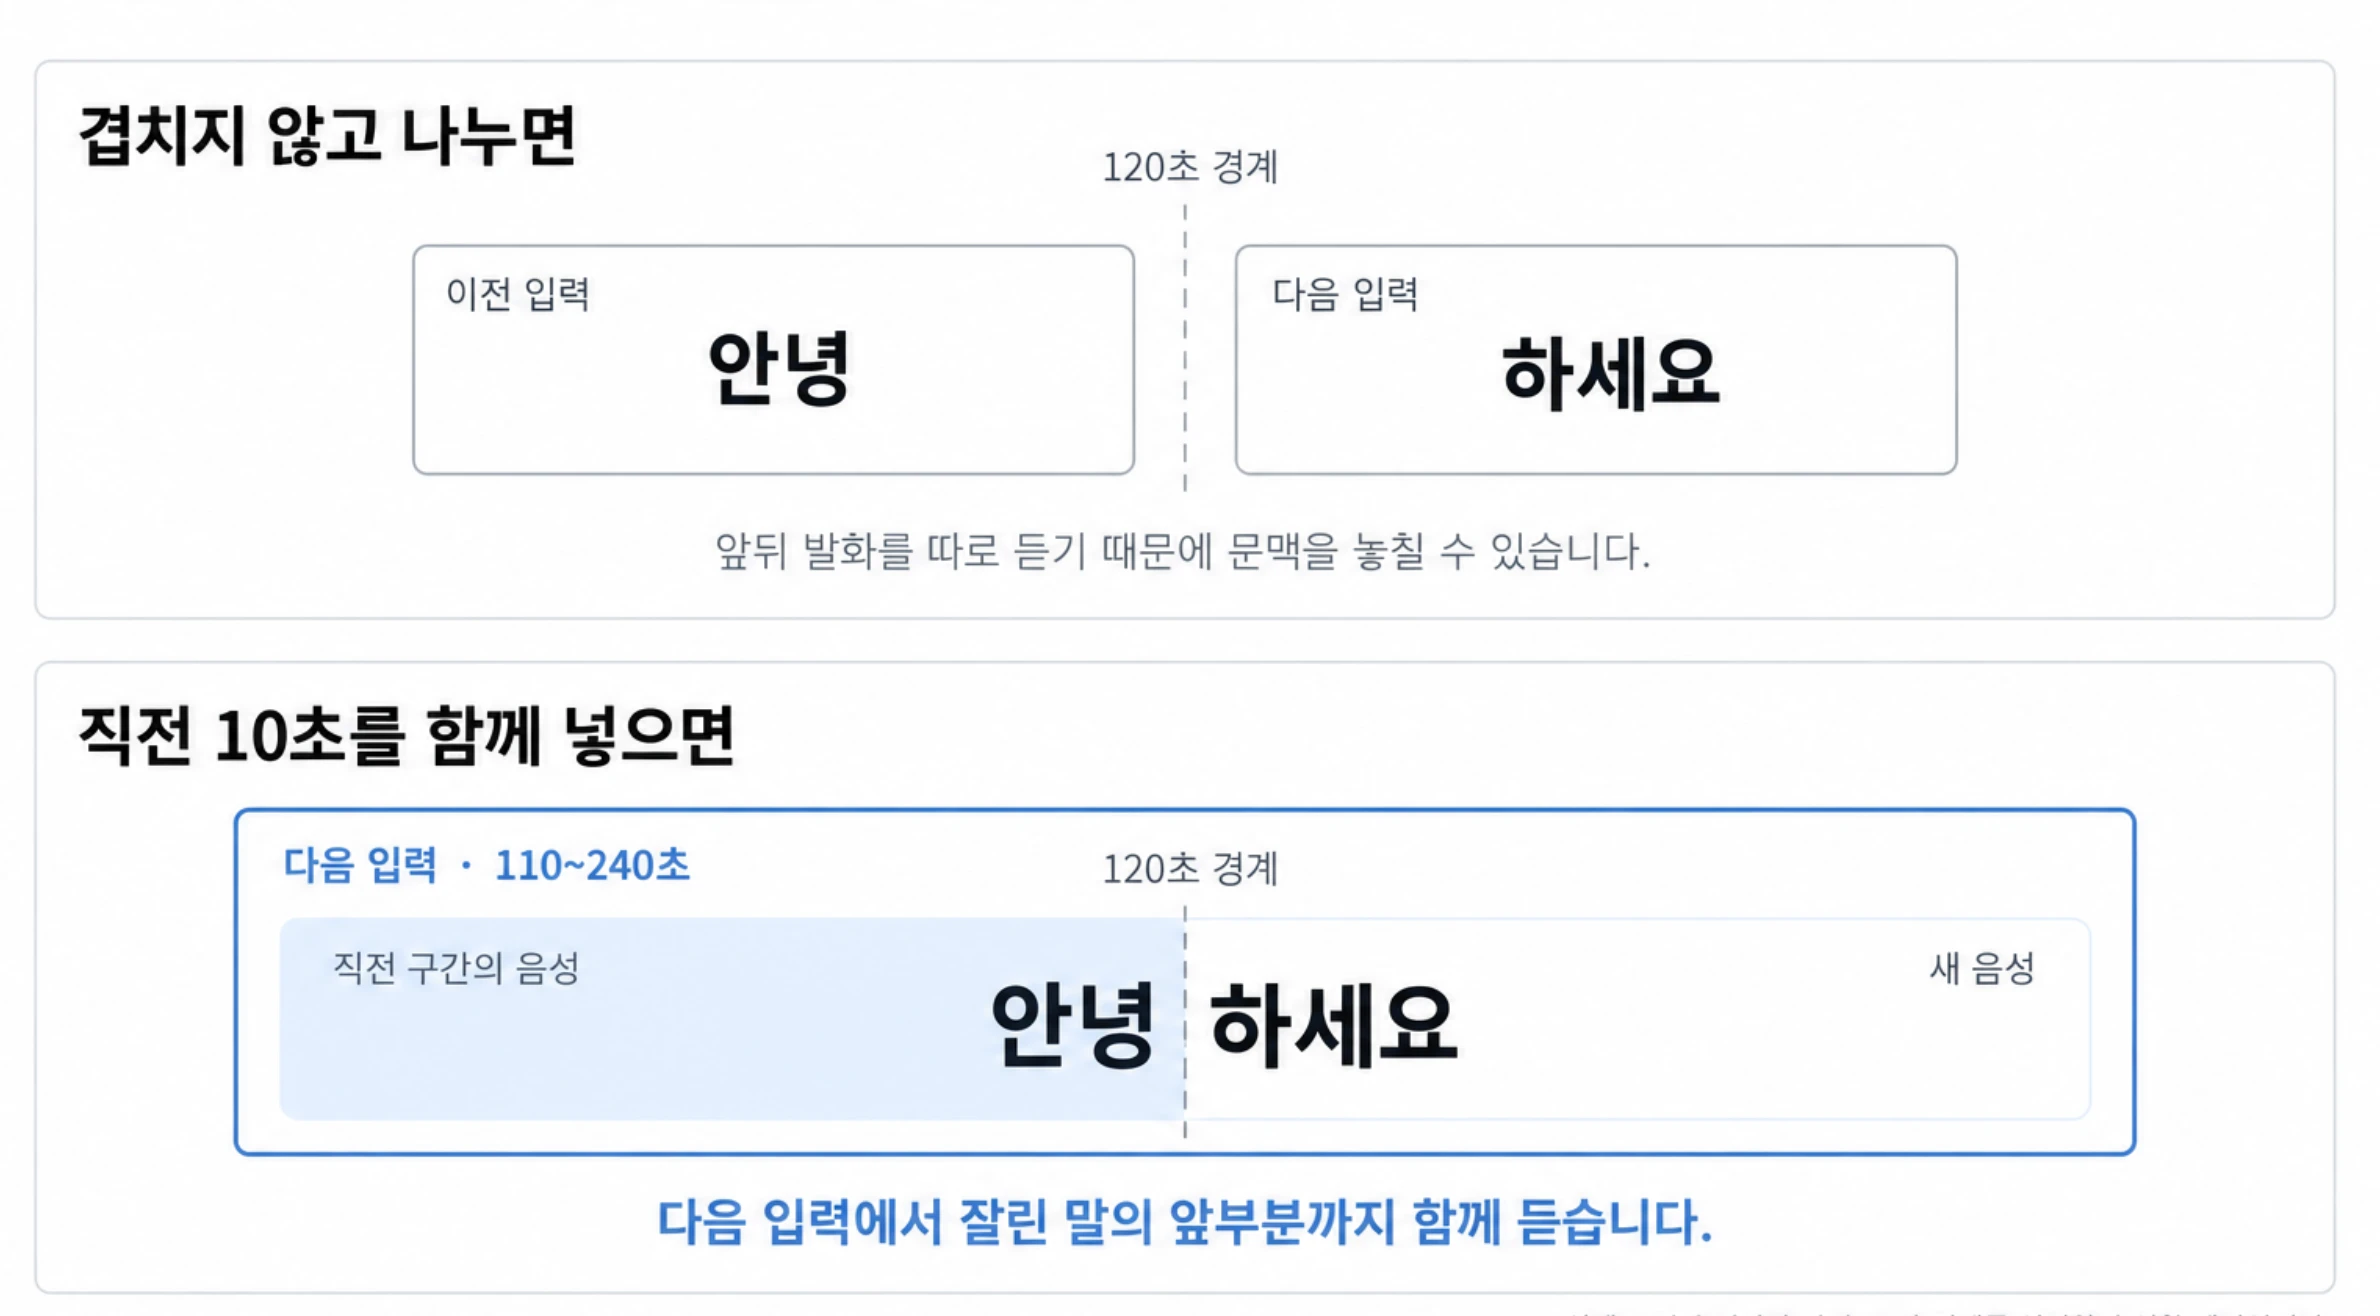
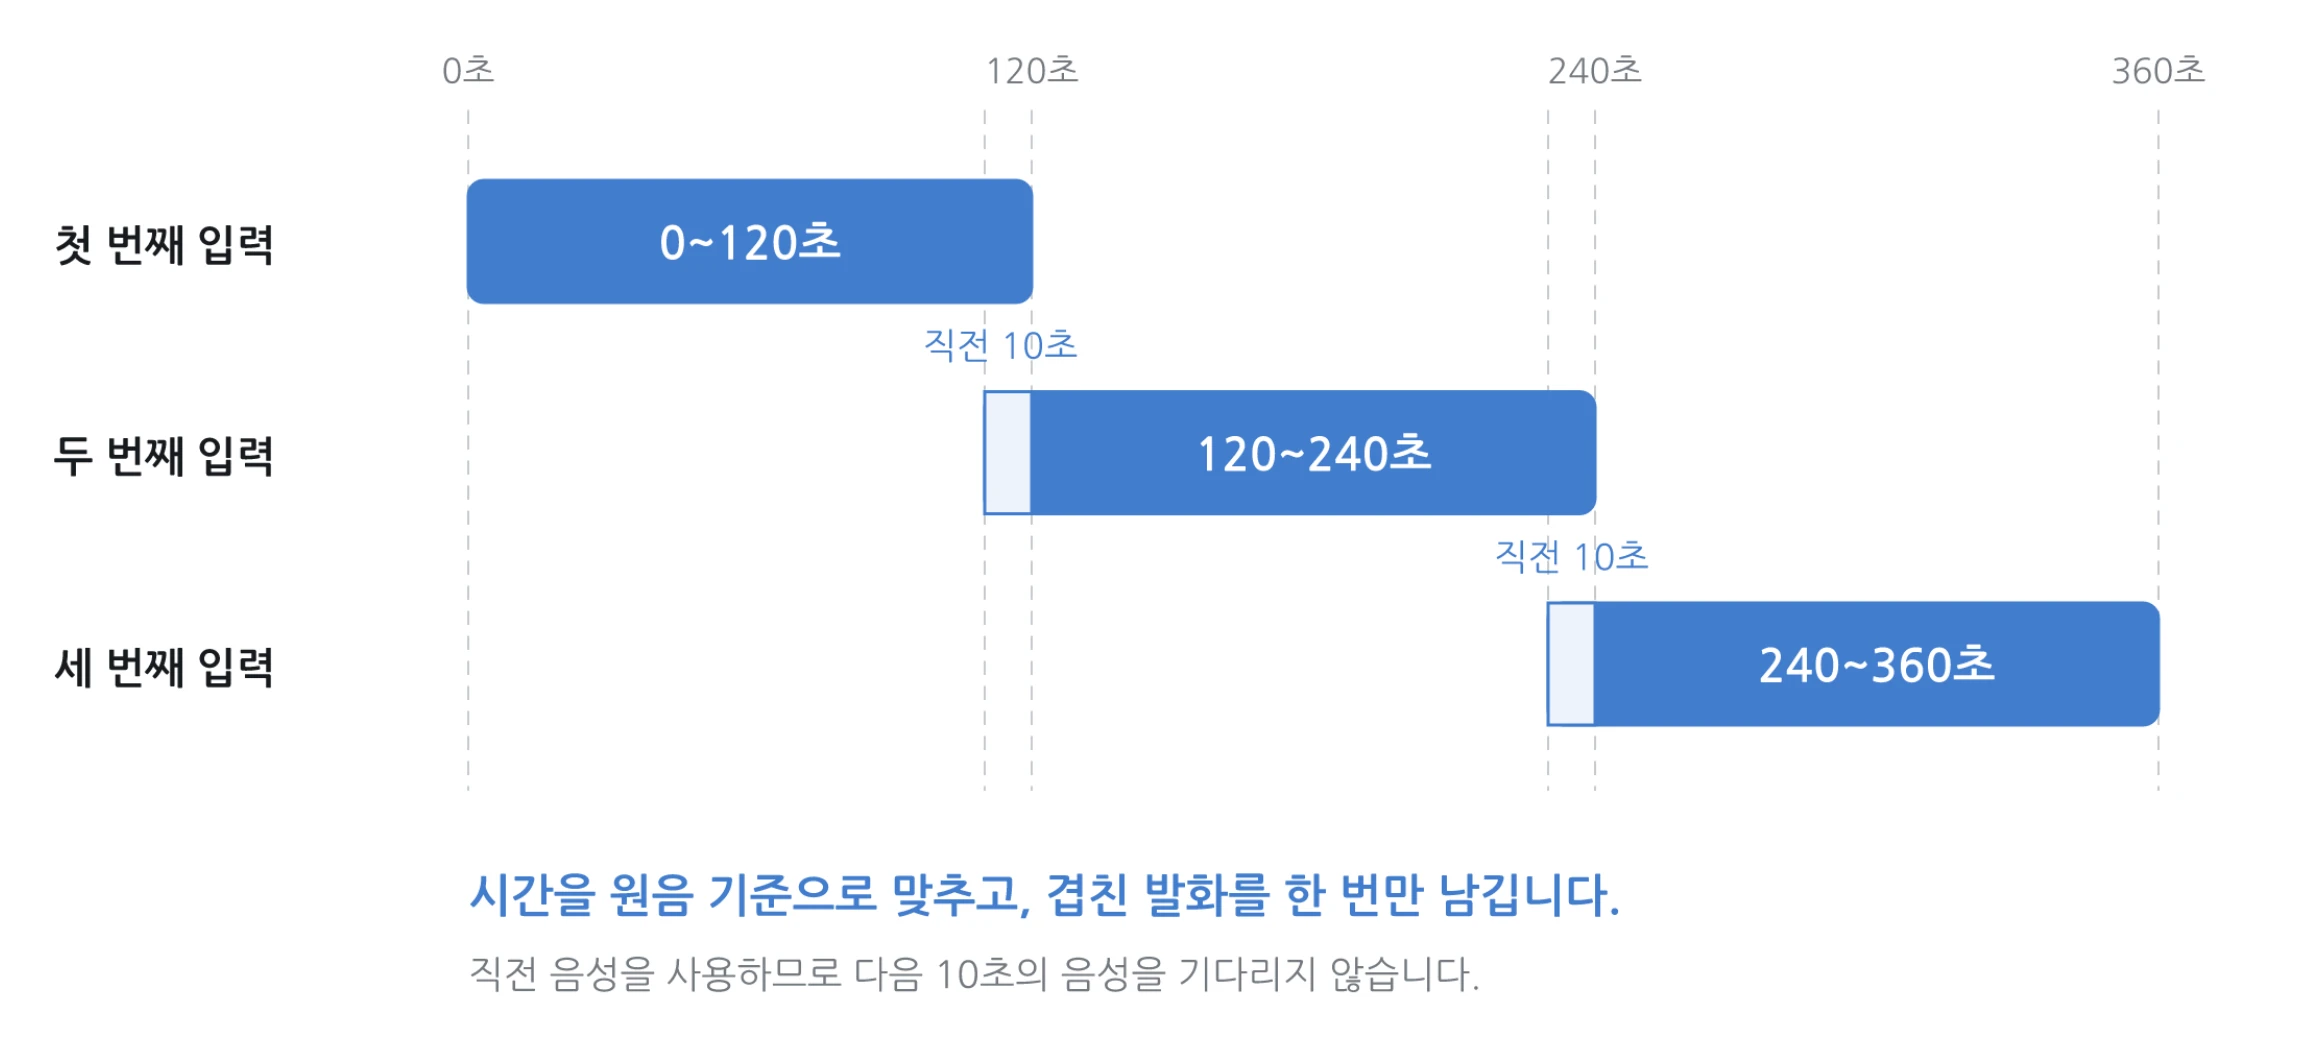
첫 입력은 0초부터 120초, 다음 입력은 110초부터 240초입니다.
앞서 녹음한 부분을 다시 쓰기 때문에 다음 음성을 더 기다릴 필요는 없었습니다.
겹친 부분을 그대로 연결하면 같은 말이 두 번 들어갈 수 있었습니다.
그래서 단어 시각을 원음 기준으로 맞추고, 겹친 부분의 단어 순서와 시각을 비교해 결과를 연결했습니다.
3. 불필요한 대기 줄이기
전사를 빠르게 하려면 모델이 처리하는 시간은 줄였지만, 개발 환경에서 시간을 나눠보니, 백엔드가 저장된 음성을 모아 AI에 전달할 파일을 만드는 데도 시간이 들었습니다.
원인을 확인하니 음성을 조금씩 복사할 때마다 DB에 계속 상태를 갱신하고 있었습니다. 작업자가 멈추면 다른 작업자가 이어받을 수 있도록 필요한 처리였지만, 이미 일정한 간격으로 갱신하는 작업이 따로 있었습니다. 파일을 복사할 때도 같은 일을 반복하면서 DB 응답을 기다리고 있었습니다.
DB 갱신은 별도 주기 작업에 맡기고, 파일을 복사할 때는 메모리에 있는 중단 여부만 확인하도록 바꿨습니다.
갱신에 실패하면 중단 표시를 바꾸고, 복사 작업이 이를 확인해 멈추도록 했습니다.
TranscriptionWindowAudioAssembler.MaterializedWindowAudio audio = assembler.materialize(
        source.orElseThrow(),
        () -> ensureActive(owned)
);
checkpoint(claim, owned);

private void ensureActive(AtomicBoolean owned) {
    if (!accepting || !owned.get() || Thread.currentThread().isInterrupted()) {
        throw new RecordingException(RecordingErrorCode.AI_INTERRUPTED);
    }
}
4. 결과는?
기다리는 시간을 줄여도 전사 품질이 크게 떨어진다면 사용하기 어려웠습니다.
그래서 같은 음성을 한 번에 전사한 결과와, 2분씩 나눠 전사한 뒤 연결한 결과를 비교했습니다.
| 처리 방식 | 합산 문자 오류율 |
|---|---|
| 전체 파일 전사 | 10.2% |
| 2분 구간 전사 | 10.8% |
이번 평가에서 두 방식의 문자 오류율 차이는 0.6%p였습니다. 2분씩 나눴을 때 오류율이 조금 높았지만, 회의 전체를 다시 전사하며 기다릴 만큼의 차이는 아니라고 판단했습니다.
이 결과를 바탕으로 녹음 중 만든 구간 결과를 그대로 최종본으로 사용했습니다.
개선 결과 및 한계
개선된 방식으로는 몇 시간을 녹화하든 마지막 전사 시간만 기다리면 되기에, 녹음 종료 후 약 30초가 걸립니다. 1시간 기준으로 20분 이상 소요되었던 것과 비교하면 약 97% 개선된 결과라고 볼 수 있습니다.
다만 동시 녹음에서는 다른 문제가 드러났습니다. 여러 명이 녹음하는 경우에 CPU 스케줄러처럼 작업들이 큐에 쌓이게 되고, 작업이 맥미니에서 전사하는 속도보다 빠르게 쌓이게 되면 녹음 전사가 점점 밀리는 현상을 확인했습니다. 동시 녹음의 처리량은 다음 개선 과제로 남았습니다.